2026-11-20 - guiral Lacotte
Deuxième billet de la série « MULE, ou comment marche un codec audio moderne ».
L’idée qui a le plus rapporté est la plus vieille
Dans le premier billet,
on a vu qu’un codec ne cherche pas à reproduire le signal : il cherche à cacher son erreur sous
le seuil de masquage. Cette erreur vient d’un geste tout bête : arrondir. Chaque coefficient
de la MDCT est remplacé par le multiple d’un pas D le plus proche, et l’écart moyen entre les
deux vaut à peu près D²/12. Diviser le pas par deux enlève 6 dB de bruit, et coûte en échange
environ un bit de plus par coefficient. Il n’y a pas de repas gratuit.
Sauf qu’il y en a un, presque. Il s’appelle la quantification codée en treillis, ou TCQ
(Trellis-Coded Quantization), et il gagne de la précision en piochant dans une grille deux
fois plus fine, tout en ne payant que le pas entier. Dans MULE, c’est l’idée qui a le plus rapporté : +0,06 d’ODG quand elle
est arrivée, puis encore +0,036 quand je l’ai poussée plus loin. À titre de comparaison, la
plupart des idées du projet se battent pour quelques millièmes.
Le plus vexant, c’est que je ne l’ai pas inventée. Elle a plus de trente ans, elle vient des
modems, elle dort dans une partie optionnelle de JPEG 2000 que personne n’utilise, et à ma
connaissance aucun codec audio grand public ne s’en sert. Ce billet raconte comment elle marche,
sans maths lourdes, et ce qu’elle a donné.
Le problème : arrondir coûte cher
Le quantificateur le plus simple, celui de la v1 de MULE, c’est une règle graduée. On pose des
graduations tous les D, et chaque coefficient est remplacé par la graduation la plus proche.
L’erreur est toujours comprise entre −D/2 et +D/2, chaque coefficient est traité seul, sans
regarder ses voisins, et le décodeur n’a qu’une multiplication à faire.
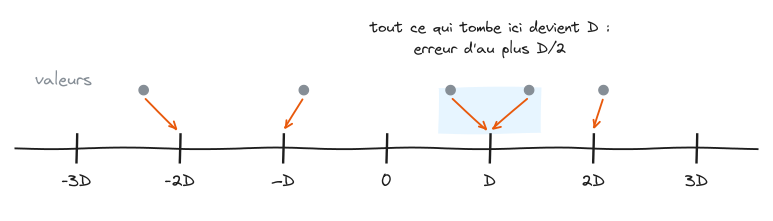
C’est simple, et c’est presque optimal. Presque. La théorie de l’information dit qu’en
quantifiant plusieurs nombres ensemble plutôt qu’un par un, on peut faire mieux, et elle dit
même de combien : à haut débit, au plus 1,53 dB de bruit en moins pour le même nombre de bits.
On appelle ça le gain de granularité. L’intuition : une règle graduée découpe l’espace en petits
cubes, et les cubes sont une façon assez maladroite de paver l’espace. En dimension 2, des
hexagones (les alvéoles d’une ruche) font mieux que des carrés ; en dimension 8 ou 24, il existe
des pavages bien plus malins encore.
Le problème, c’est que ces pavages malins, il faut les stocker ou les calculer, et c’est
exactement ce que font les dictionnaires de Vorbis (ses codebooks) ou la PVQ d’Opus, avec les
conséquences que vous connaissez si vous avez lu le premier billet : de la RAM, ou une migraine.
La TCQ, elle, en récupère environ 1 dB sur les 1,53 possibles avec 8 états, à haut débit et
sans aucun dictionnaire. C’est là toute sa magie. À nos débits, un peu plus d’un bit par
coefficient, ce sera moins : on y revient plus bas.
L’astuce : deux règles graduées qui s’entrelacent
On part d’une règle graduée deux fois plus fine : des graduations tous les D/2. Si on avait
le droit de toutes les utiliser, on aurait le bruit du demi-pas, et la facture du demi-pas.
On range alors ces graduations en quatre familles, chacune revenant toutes les deux
graduations : appelons-les D0, D1, D2 et D3, et elles se suivent dans cet ordre le long de la
règle, D0, D1, D2, D3, D0, D1… Puis on les regroupe par deux :
- la règle paire, faite de D0 et D2 : une graduation sur deux, donc un pas de D ;
- la règle impaire, faite de D1 et D3 : l’autre graduation sur deux, elle aussi au pas de D,
mais décalée d’un demi-pas.
Chacune des deux règles a le même pas que le quantificateur scalaire : elle coûte donc le même
nombre de bits. Mais ensemble, elles forment la règle fine.
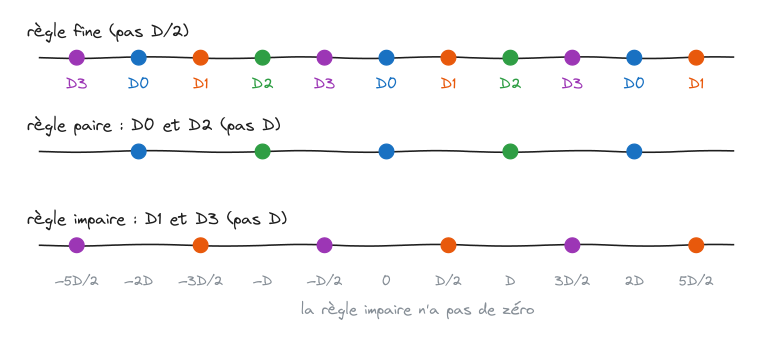
Si j’ai deux règles, il me faut un bit pour dire laquelle j’utilise ? Où se cache le gain ?
C’est toute l’astuce : pour chaque coefficient, on n’a le droit qu’à une seule des deux règles
graduées, et c’est le choix fait sur le coefficient précédent qui décide laquelle. Avoir pris
une graduation de la famille D0 plutôt que D2, par exemple, c’est choisir une valeur pour ce
coefficient-ci, et cette valeur fixe la règle imposée au suivant. Le bit qui dit « quelle règle »
n’est donc jamais envoyé : il voyage dans la valeur du coefficient d’avant, que le décodeur lit
de toute façon.
Une rotation fixe, D0, D1, D2, D3 à chaque coefficient, ne rapporterait rien : l’encodeur n’aurait
plus aucun choix, et chaque coefficient serait simplement arrondi sur une règle imposée d’avance.
Tout le gain vient de la liberté de choisir son chemin.
Comme chaque choix engage le coefficient suivant, l’encodeur n’arrondit
plus chaque valeur à l’aveugle : il cherche la suite de choix qui, sur toute la bande, colle
au mieux au signal, en comptant aussi les bits dépensés. Selon les chemins, un coefficient finit
souvent sur la règle qui l’arrange. Dans MULE, à débit égal, l’erreur baisse d’environ 0,4 dB par
rapport à l’arrondi simple. On est loin des 6 dB du demi-pas, mais pour un décodeur qui ne paie
presque rien, c’est beaucoup, et les mesures de qualité perçue y gagnent plus encore (on y vient).
Le décodeur, lui, n’a besoin d’aucune information supplémentaire : il connaît les valeurs qu’il
a déjà décodées, donc il connaît la règle en cours. Il lit un index, comme avec le scalaire, et
la règle lui dit à quelle graduation il correspond.
Un détail qui m’a fait sourire en l’implémentant : la règle impaire n’a pas de zéro (ses
graduations tombent à ±D/2, ±3D/2…). Quand on est sur elle, le signe est donc toujours envoyé,
même pour une valeur minuscule.
Ça coûte un bit. L’encodeur a donc intérêt à s’organiser : en choisissant bien les coefficients
précédents, il peut arriver sur la règle paire juste quand se présente une valeur proche de zéro.
Encore faut-il des règles de passage précises entre les deux règles graduées : c’est le treillis.
Le treillis : une machine à huit états
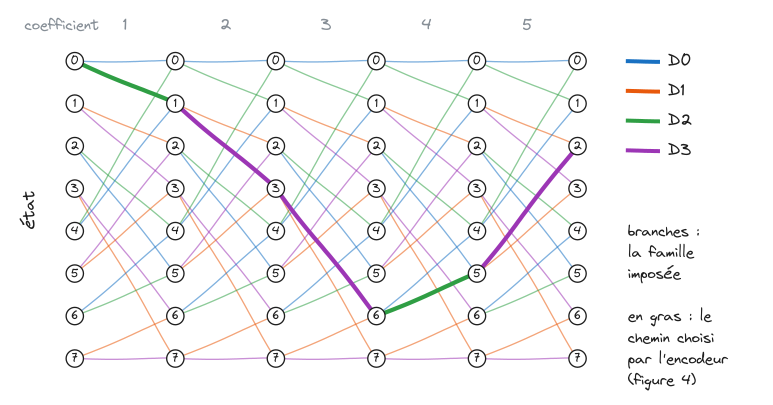
« Le choix précédent décide de la règle suivante » : il faut bien une règle de transition précise, et
c’est le treillis qui la donne. C’est une petite machine à états. À chaque coefficient, la
machine est dans l’un de ses 8 états ; l’état dit quelle règle graduée est permise, et le choix
de la famille fait passer la machine dans l’état suivant. Dans MULE, depuis l’état t, on passe
à l’état (2t + 0) ou (2t + 1), modulo 8, selon la famille choisie. Ce sont exactement les tables
de la partie 2 de JPEG 2000 : je n’ai rien inventé.
D’où ça vient ? Des modems. Au début des années 1980, Gottfried Ungerboeck a montré qu’en
choisissant les points émis sur une ligne téléphonique selon une machine à états de ce genre, on
gagnait plusieurs dB de robustesse sans élargir la bande : la modulation codée en treillis,
qui a fait les beaux jours des modems téléphoniques (V.32 et V.32bis, 9 600 et 14 400 bit/s).
En 1990, Michael Marcellin et Thomas Fischer ont retourné l’idée : ce qui protège des points
contre le bruit d’une ligne peut aussi placer des niveaux de quantification au plus près d’un
signal. C’est la TCQ. Elle a fini dans JPEG 2000, puis, sous une forme cousine
(la quantification dépendante), dans le codec vidéo VVC.
Le coût pour le décodeur sur le baladeur : une table de 16 entrées, une parité et un décalage par
coefficient. Comparé à une IMDCT, c’est invisible.
Viterbi : choisir tout le chemin d’un coup
Reste le vrai travail, côté encodeur : trouver la meilleure suite de choix. On ne peut pas
décider coefficient par coefficient, parce qu’un choix excellent maintenant peut imposer une
règle catastrophique au coefficient suivant. Et on ne peut pas essayer toutes les suites : avec
deux familles possibles par coefficient, une bande de 64 coefficients compte 2⁶⁴ chemins.
L’astuce s’appelle l’algorithme de Viterbi, et c’est un peu celui du routage sur un GPS (Une autre de mes passions).
Pour trouver le plus court chemin de Paris à Marseille, le GPS n’essaie pas toutes les routes : il retient, pour chaque
carrefour, le meilleur chemin qui y mène, et oublie les autres, puisque tout trajet qui passe
par ce carrefour a intérêt à y arriver par le meilleur chemin. Viterbi fait la même chose avec
les états du treillis : coefficient après coefficient, il garde pour chacun des 8 états le
meilleur chemin qui y arrive, et rien d’autre. À la fin de la bande, il prend le meilleur des 8
et remonte le chemin. Huit chemins à suivre au lieu de 2⁶⁴ : l’encodeur tourne environ deux fois
moins vite qu’avec le scalaire.
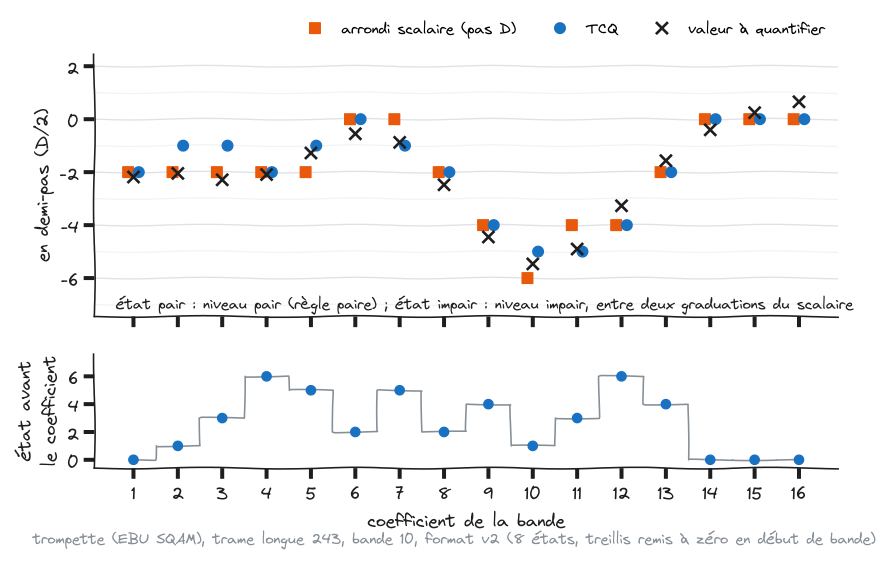
Sur cette bande, prise au hasard, la TCQ ne fait pas une erreur plus petite que l’arrondi : elle
cherche le meilleur compromis entre erreur et bits, et c’est sur des milliers de bandes que le
gain apparaît. Ce qu’on voit bien, en revanche, c’est la règle du jeu : chaque fois que l’état est
impair, le niveau choisi tombe entre deux graduations du scalaire.
Ce qu’on minimise, c’est « erreur au carré + λ × bits » : le compromis débit-distorsion du premier
billet, au niveau du coefficient. Et il a fallu le régler, parce que λ s’est révélé capricieux.
Sur mon corpus de réglage :
- λ = 0 (on ne regarde que l’erreur) : 4,8 % de débit en plus, et 15 extraits qui se
dégradent ;
- λ = 0,3 : l’optimum, un seul extrait en recul (des triangles, évidemment) ;
- λ = 1 : 59 extraits en recul sur 66. À trop vouloir économiser, le treillis préfère les
niveaux bon marché, quitte à s’éloigner du signal, et sur un son tonal, un partiel qui disparaît
ou qui change de niveau, ça s’entend.
Ce qui est vraiment écrit dans le fichier
Reste une question que je me suis posée tard, et que vous vous posez peut-être : à chaque
coefficient, le Viterbi choisit une branche parmi deux. Comment le décodeur connaît-il ces choix ?
Il faudrait les lui envoyer, un bit par coefficient, non ?
Non : les choix ne sont jamais écrits. Ce qui est écrit, c’est la valeur de chaque
coefficient, exactement comme avec le scalaire : un index dans la règle en cours, et un signe.
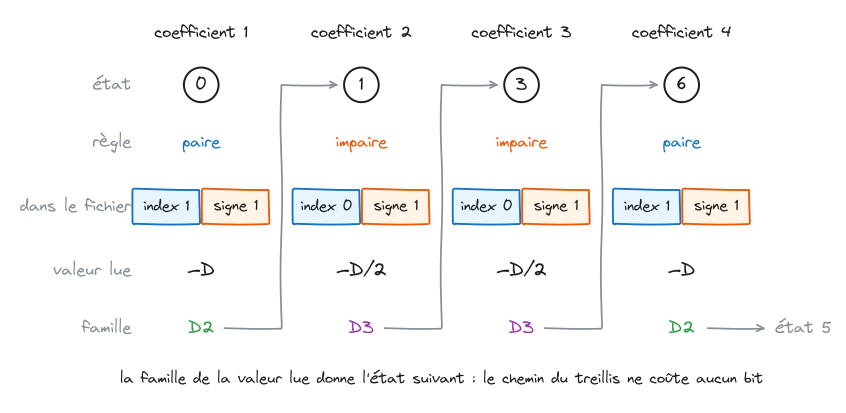
Prenons les deux premiers coefficients de la figure 4. Le treillis part de l’état 0, qui est
pair : on est sur la règle paire, dont les graduations sont 0, ±D, ±2D… L’encodeur écrit « index 1,
négatif », et le décodeur lit −D. Or −D appartient à la famille D2 (les multiples impairs de D), et
c’est la famille qui désigne la branche : la machine passe dans l’état 1. État impair, donc règle
impaire, graduations ±D/2, ±3D/2… L’encodeur écrit « index 0, négatif » : le décodeur lit −D/2,
famille D3, et la machine passe dans l’état 3. Et ainsi de suite, coefficient après coefficient :
c’est le chemin dessiné en gras sur la figure 3.
Concrètement, chaque coefficient occupe dans le fichier, dans l’ordre :
- un symbole d’index, de 0 à 6, compressé par le codeur entropique avec un modèle qui dépend
des deux coefficients précédents (ce sera le billet 3). Sur la règle paire, l’index u vaut u·D ;
sur la règle impaire, (u + ½)·D. Le symbole 7 sert d’échappement pour les grands index : il est
suivi de leur longueur, puis de quelques bits bruts ;
- le signe, sur un bit brut (1 pour négatif), qui n’est pas compressé : un coefficient de la
MDCT a autant de chances d’être positif que négatif, il n’y a rien à gagner. Sur la règle paire,
il n’est écrit que si l’index n’est pas nul, puisque zéro n’a pas de signe ; sur la règle
impaire, il est toujours écrit, puisque son plus petit niveau est déjà ±D/2.
Nos deux coefficients s’écrivent donc « symbole 1, bit de signe 1 », puis « symbole 0, bit de
signe 1 » : sur la règle impaire, même l’index 0 a son signe. Et ces bits de signe pèsent lourd :
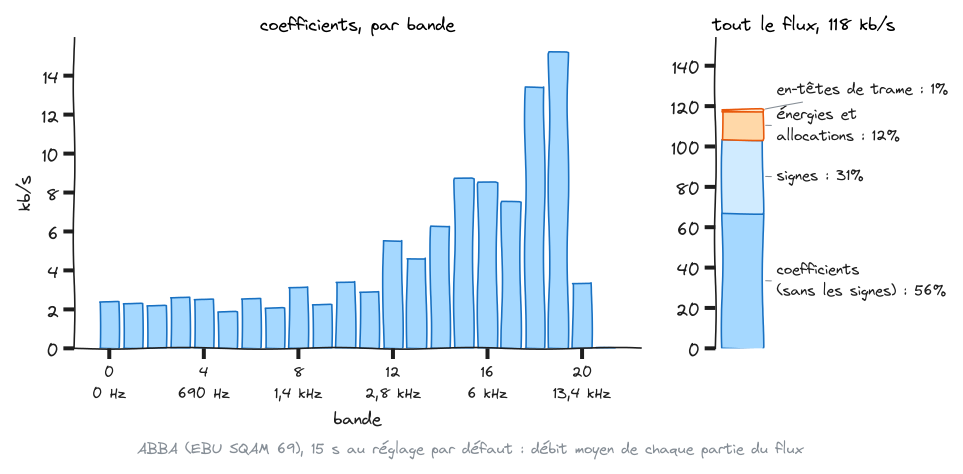
près d’un tiers du flux sur l’extrait d’ABBA du premier billet (figure 9).
Le choix de la branche est donc contenu dans la valeur elle-même : choisir −D plutôt que 0 ou −2D,
c’est à la fois choisir une valeur et choisir un chemin. Et cette valeur, il faut l’envoyer de
toute façon. Elle coûte le prix d’un index sur une règle au pas D, c’est-à-dire ce que paie le
quantificateur scalaire, et le codeur entropique (billet 3) la compresse de la même façon. Le
chemin du Viterbi ne coûte donc pas un bit par choix : il ne coûte rien. À un détail près, on vient
de le voir : sur la règle impaire, le signe est toujours payé. C’est pour ça que le Viterbi compte les
bits dans son coût, et pas seulement l’erreur : quand il hésite entre deux chemins, il compare le
prix des valeurs qu’ils imposent, puisque le chemin lui-même est gratuit.
Au départ, MULE n’avait pas de TCQ. Mes notes de conception proposaient trois quantificateurs
pour la forme des bandes : le scalaire tout simple (le A), la TCQ (le B) et une version améliorée
de la PVQ d’Opus (le C). J’ai construit le codec avec le A, parce que c’était le plus simple,
puis j’ai branché le B et le C à sa place.
Résultat sur les 30 extraits de test, à débit égal : la TCQ gagne +0,063 d’ODG à 128 kb/s et
+0,037 à 160, sans un seul extrait en recul. L’écart avec Opus sur la note de base de PEAQ
diminue d’environ un tiers. Et pour une fois, mes oreilles ont confirmé : en écoute à l’aveugle à
160 kb/s, sur six extraits choisis pour être difficiles (seize fois d’affilée les mêmes
triangles, puis seize fois les mêmes castagnettes, et rebelote pour chaque version : une
épreuve), le scalaire était transparent sur cinq extraits sur six (les triangles, encore ces
satanés triangles, étaient au seuil de détection) et la TCQ sur les six.
La PVQ, elle, a perdu. Pas de beaucoup en moyenne, mais lourdement sur les sons tonals : −0,64 sur
les triangles, −0,43 sur le glockenspiel (une sorte de
xylophone, en métal). Honnêtement, la PVQ est compliquée à appréhender : c’est de la géométrie en
dimension N, avec des problèmes de densité de points et de distance. Je ne sais pas pour vous,
mais moi, j’ai du mal à visualiser les pôles d’une sphère de dimension 12. La documentation
d’Opus est imbuvable. J’ai essayé de lire deux ou trois papiers sur le sujet, mais il faut se
rendre à l’évidence : je suis incapable de comprendre suffisamment la PVQ pour la configurer. En
plus, elle perdait face à la TCQ.
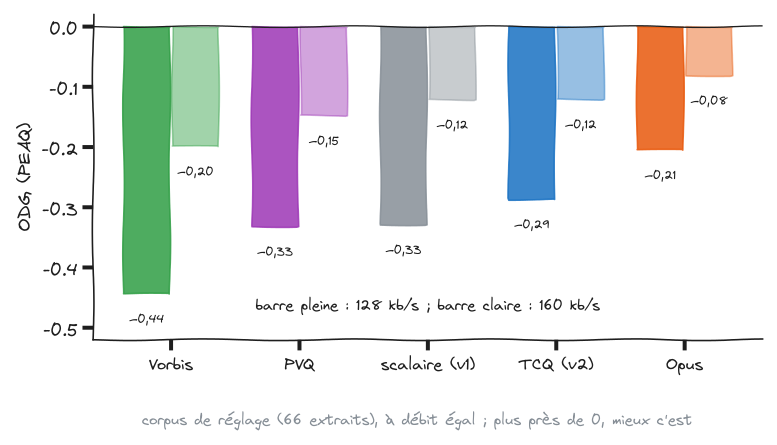
La TCQ est devenue le seul quantificateur du format v2.
La v3 : plus d’états, et un seul Viterbi pour toute la trame
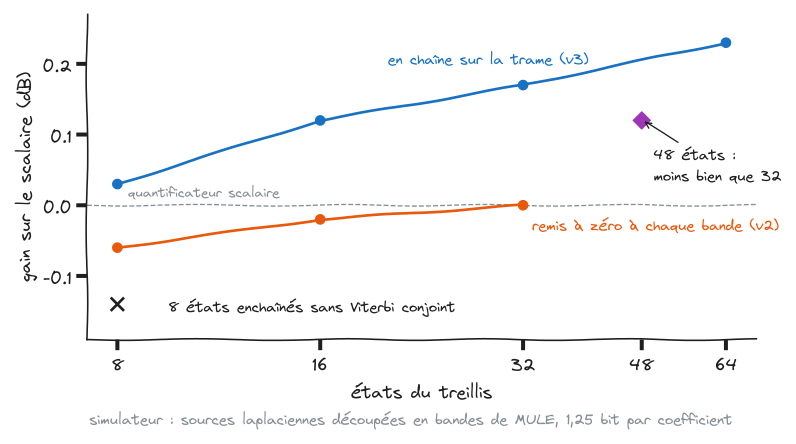
En étudiant le treillis sur un petit simulateur, je me suis rendu compte d’un phénomène
intéressant : il perdait surtout dans les bandes courtes, celles des graves. Pourquoi ? Le
treillis repartait de l’état 0 au début de chaque bande. Or un treillis qui part d’un seul
état met trois coefficients à ouvrir ses chemins (il faut le temps que les huit états soient atteignables).
Dans une bande de 512 coefficients, on s’en moque ; dans les bandes graves de MULE, qui en comptent 8,
c’est presque la moitié de la bande qui se fait avec un état dégradé.
L’idée évidente : ne pas remettre le treillis à zéro, laisser chaque bande partir de l’état où la
précédente a fini. J’ai d’abord vérifié sur un petit simulateur, avant de toucher au codec. Et
l’idée évidente était fausse : enchaîner les bandes naïvement, chacune dans l’état laissé par la
précédente, fait moins bien que de repartir à zéro (−0,14 dB à 1,25 bit par coefficient, le
régime de MULE). La fin d’une bande, choisie sans penser à la suivante, lui impose un état de
départ qui l’arrange rarement.
Ce qui marche, c’est de faire un seul Viterbi sur toutes les bandes de la trame, pour que la
fin de chaque bande soit choisie en même temps que le début de la suivante. Et une fois le
treillis enchaîné, on peut lui donner plus d’états : avec des bandes trop courtes, des états
supplémentaires n’avaient pas le temps de servir. Un treillis de 64 états met six coefficients à
ouvrir tous ses chemins : dans une bande de 8, c’est presque toute la bande ; sur une trame
entière, c’est négligeable, et les états supplémentaires offrent à l’encodeur bien plus de
chemins entre lesquels choisir. Le simulateur donnait +0,17 dB à 32 états, +0,23 dB à 64.
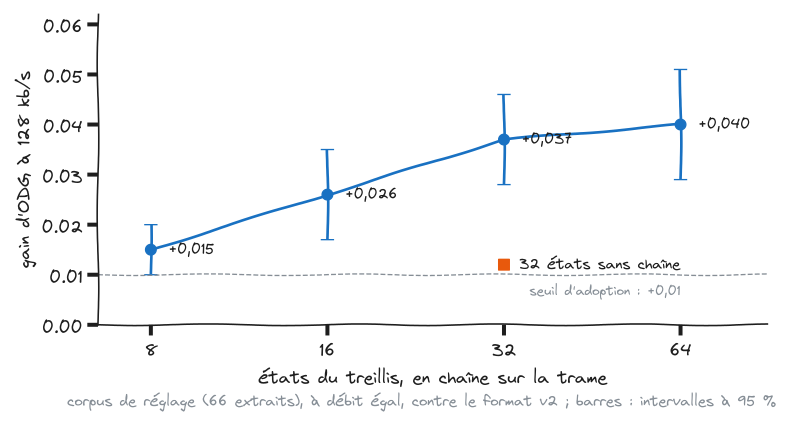
Dans le codec, sur le corpus de réglage, le gain monte avec le nombre d’états, de moins en moins
vite : +0,015 d’ODG à 8 états en chaîne, +0,026 à 16, +0,037 à 32, +0,040 à 64. Confirmé sur les
extraits de test : +0,036 à 128 kb/s pour le format v3, toutes les mesures sont concordantes.
Le plus gros gain de l’encodeur depuis le passage à la TCQ.
J’ai évidemment essayé 48 états, parce que pourquoi pas, et parce qu’entre 32 et 64 il y avait
peut-être un compromis. Il n’y en avait pas : 48 états font moins bien que 32 (+0,12 dB contre
+0,17). Les bons treillis viennent des codes convolutifs des télécoms, et ils aiment les
puissances de deux. J’aurais pu m’en douter, mais c’est plus simple de le mesurer.
Et pourquoi s’arrêter à deux règles ? Si deux règles décalées d’un demi-pas font gagner quelque
chose, quatre règles décalées d’un quart de pas, piochées dans une grille quatre fois plus fine,
devraient faire mieux. La question est naturelle, et Ungerboeck se l’était déjà posée pour ses
modems : doubler l’alphabet donne l’essentiel du gain, le quadrupler presque rien de plus. Je l’ai
quand même vérifié sur le simulateur. Résultat, à 1,25 bit par coefficient : entre +0,01 et
+0,03 dB selon le nombre d’états, soit rien du tout. Et il y a un prix caché : trois règles sur
quatre n’ont pas de zéro, et paient le signe sur toutes les petites valeurs, qui sont justement
la majorité des coefficients de MULE. Deux règles, c’est très bien.
Les coûts, maintenant. Pour le décodeur : 256 octets d’état en plus, et rien d’autre. Pour
l’encodeur, c’est une autre histoire : un Viterbi huit fois plus large, qui a fait tomber
l’encodage à 1,9 fois le temps réel. L’astuce pour regagner de la vitesse : le choix de
l’allocation de chaque bande (essayer a−1, a, a+1, voir le billet 1) a besoin d’estimer le coût
de chaque option, mais pas au bit près. Je fais donc ces estimations sur un petit treillis de
8 états, et je ne sors le grand treillis de 64 états que pour le codage final. Même qualité, à la
mesure près, et l’encodeur est revenu à environ quatre fois le temps réel.
Je ne dirais pas que c’est un échec, mais que cela n’a pas marché
Le treillis a eu droit à son petit cimetière d’idées innovantes :
- Des contextes qui connaissent l’état. Le codeur entropique devine mieux un
symbole s’il sait sur quelle règle graduée on se trouve. Gain : 0,42 % de débit, sous mon seuil
de 1 %, pour 3 Kio de RAM en plus sur le cœur B. Non.
- Un treillis plus riche, dont l’état porterait aussi le type de la bande. Fausse bonne idée :
ce que sait la bande, c’est aux contextes du codeur entropique de l’exploiter, pas au treillis.
- La TCVQ, la version vectorielle de la TCQ : environ 0,5 dB de plus en théorie, et un décodeur
bien plus lourd. Pas sur mon baladeur.
- Un réglage automatique de tous les paramètres autour du treillis de 64 états, par un
algorithme d’optimisation (CMA-ES) : +0,004 sur les extraits qui servaient à régler, rien sur
les autres. Les réglages faits à la main étaient déjà bons.
Pourquoi personne ne l’utilise ?
Une idée de 1990, venue des modems et passée par l’image et la vidéo, a rapporté à MULE plus que tout mon travail sur
la psychoacoustique. Elle coûte presque rien au décodeur et ne demande aucun dictionnaire. Alors
pourquoi ne la trouve-t-on dans aucun codec audio grand public ?
Je n’ai pas de réponse sérieuse. Peut-être les brevets, à l’époque où AAC et Vorbis ont été
conçus. Peut-être parce que la PVQ d’Opus en récupère une partie autrement, en quantifiant les
coefficients ensemble. Peut-être parce que personne n’a eu besoin de serrer un codec dans 30 Kio
sur un Cortex-M3. Si vous connaissez la réponse, je suis preneur.
Au prochain épisode : une fois quantifiés, ces index doivent encore être écrits avec le moins de
bits possible, et on verra que la compression ne vient pas du codeur, mais du modèle.
2026-11-19 - guiral Lacotte
Premier billet de la série « MULE, ou comment marche un codec audio moderne ».
Je bidouille encore mon baladeur chinois à soixante euros
J’ai porté Ogg Vorbis et Ogg Opus sur l’Echo Mini de Snowsky, un petit baladeur audio. Sur le
papier, c’était une formalité : prendre des bibliothèques qui tournent partout depuis quinze
ans, les compiler, câbler l’entrée et la sortie. Dans la vraie vie, je me suis pris deux murs.
Le premier : l’Echo Mini tourne sur un Cortex-M3, sans unité de calcul en virgule flottante.
Pas de float, ou alors émulé en logiciel, c’est-à-dire à la vitesse d’un escargot.
Le second : le cœur dédié à l’audio, le « cœur B », n’a accès directement qu’à
très peu de RAM. 128 Kio pour le code, 148 Kio pour les données. Pour tout. Le décodeur,
ses tables, ses tampons d’entrée et de sortie. Une fois le décodeur et ses tables installés, il
ne reste pas de quoi garder ne serait-ce que 40 ms de son d’avance (PCM).
Vorbis, d’abord. Il embarque des codebooks (des dictionnaires de quantification envoyés
dans l’en-tête de chaque fichier) et des tables d’IMDCT (la transformée inverse, on y
reviendra) qui prennent tellement de place qu’il faut les étaler sur deux banques de mémoire.
Il ne reste presque rien pour les tampons. Le portage d’origine trichait d’ailleurs avec
l’option de compilation low_memory de Tremor, qui dégradait la qualité de façon audible.
Opus, ensuite. Pas de codebooks, mais la PVQ (Pyramid Vector Quantization), une technique
infernale pour coder de façon compacte des vecteurs de dimension N et de longueur unité.
Je vais être honnête : je n’ai pas compris grand-chose à son fonctionnement. On répartit des
points sur une sphère de dimension N pour représenter un vecteur unitaire. Jusque-là, j’arrive à
suivre. Puis on applique plusieurs fois le même mécanisme (coordinate-wise power), ce qui, au
bout d’un moment, crée tout un tas de problèmes : des points répartis de façon pas uniforme, un
écart entre la distance de Manhattan qu’on emploie et la distance euclidienne qu’on voudrait.
De quoi permettre à plein de gens très brillants d’écrire plein d’articles. C’est clairement
trop compliqué pour moi : je suis trop vieux pour me souvenir de mes cours de géométrie des
réseaux euclidiens.
Dernier point : comme beaucoup de baladeurs, l’Echo Mini embarque des accélérateurs matériels.
Il fait presque toute la synthèse d’un MP3 en matériel (on s’en fiche un peu), mais il sait
aussi faire des choses plus lourdes et bien plus intéressantes : des FFT, des FFT inverses et
des IMDCT, pensées pour l’AAC et le Vorbis. Sur Tremor, l’implémentation en virgule fixe de
Vorbis, l’IMDCT matérielle va environ quatre fois plus vite que la logicielle. Opus, lui, n’en
profite pas : ses trames de 20 ms font 960 échantillons à 48 kHz, ce qui demande des FFT de
480 points, alors que l’accélérateur ne connaît que les puissances de deux. Tout se fait en
logiciel.
Alors j’ai fait ce que tout développeur raisonnable aurait évité : je me suis lancé dans le
défi un peu idiot d’écrire mon propre codec audio. Avec un cahier des charges court :
- Une seule mission : transcoder des CD pour les écouter sur un baladeur. Pas de vidéo à
48 kHz, pas de visioconférence, pas de pertes de paquets sur le réseau, pas de faible
latence, pas de 7.1 : rien de tout ce qu’on attend d’un codec moderne généraliste.
- Un décodeur en virgule fixe, parce que le matériel n’a pas de FPU.
- Capable d’utiliser les accélérateurs matériels.
- Simple. Vorbis et Opus ont parfois des conceptions un peu tordues, nées pour contourner
les brevets logiciels de leur époque. Ces brevets ont expiré : on peut faire simple.
- Transparent sur une écoute de CD entre 128 et 160 kb/s, quelque part entre les
performances de Vorbis et celles d’Opus.
Pour rigoler, je l’ai appelé MULE : c’est un hybride de Vorbis, d’Opus et d’AAC. Comme une
mule, c’est petit, têtu, et ça n’aura pas de descendance. Le code, la spécification du format
et toutes les mesures sont sur GitHub : berettavexee/mule-audio.
Dans ce billet, on va suivre une seule trame de musique (23 millisecondes de son) depuis le
fichier WAV jusqu’au paquet compressé. Pour chaque étage, trois questions : de quoi un codec
a-t-il besoin, comment les autres s’y prennent (MP3, AAC, Vorbis, Opus), et ce que MULE
a choisi, et pourquoi.
Le principe : jeter ce qu’on n’entend pas
Le besoin
Un CD, c’est 1 411 kb/s : 44 100 échantillons par seconde, sur 16 bits, en stéréo. MULE vise
128 kb/s, onze fois moins. Un compresseur sans perte comme FLAC tourne entre 600 et 900 kb/s :
il reproduit le signal à l’identique, c’est ce qu’on appelle une compression sans perte. Pour
diviser par onze, il faut éliminer de l’information, beaucoup d’information : c’est la
compression avec perte. L’astuce consiste à jeter celle que l’oreille n’entendra pas. Ce n’est
pas nouveau : le MP3 le fait depuis plus de trente ans.
Un codec perceptif ne cherche donc pas à reproduire le signal. Il cherche à reproduire ce
qu’on en perçoit, avec trois idées :
- Passer en fréquences. L’oreille interne est un analyseur de fréquences. Et supprimer ou
affaiblir une fréquence directement dans les échantillons PCM, c’est mission impossible ;
en fréquences, c’est un coefficient à arrondir plus grossièrement.
- Déterminer ce qui est masqué. Un son fort rend inaudibles les sons faibles voisins. Le
modèle psychoacoustique calcule, pour chaque morceau du spectre, le niveau sous lequel
l’oreille ne remarque rien.
- Maintenir l’erreur de quantification sous ce masque. Quantifier, c’est arrondir, donc
ajouter du bruit. Tout l’art consiste à doser cet arrondi pour que le bruit reste caché sous
le masque. Là où le masque est haut, j’arrondis plus grossièrement et j’utilise moins de bits.
Ce que font les autres
Tous les codecs musicaux grand public suivent ce schéma : MP3, AAC, Vorbis, et la partie CELT
d’Opus. Opus est en fait un hybride : il a aussi un moteur pour la parole, SILK, qui travaille
dans le domaine temporel par prédiction linéaire, comme les codecs téléphoniques. Il s’en sert
à bas débit et pour la voix.
Le choix de MULE
Un codec à transformée pur, sans moteur parole : MULE ne code que de la musique, à des débits où
CELT seul suffit à Opus.
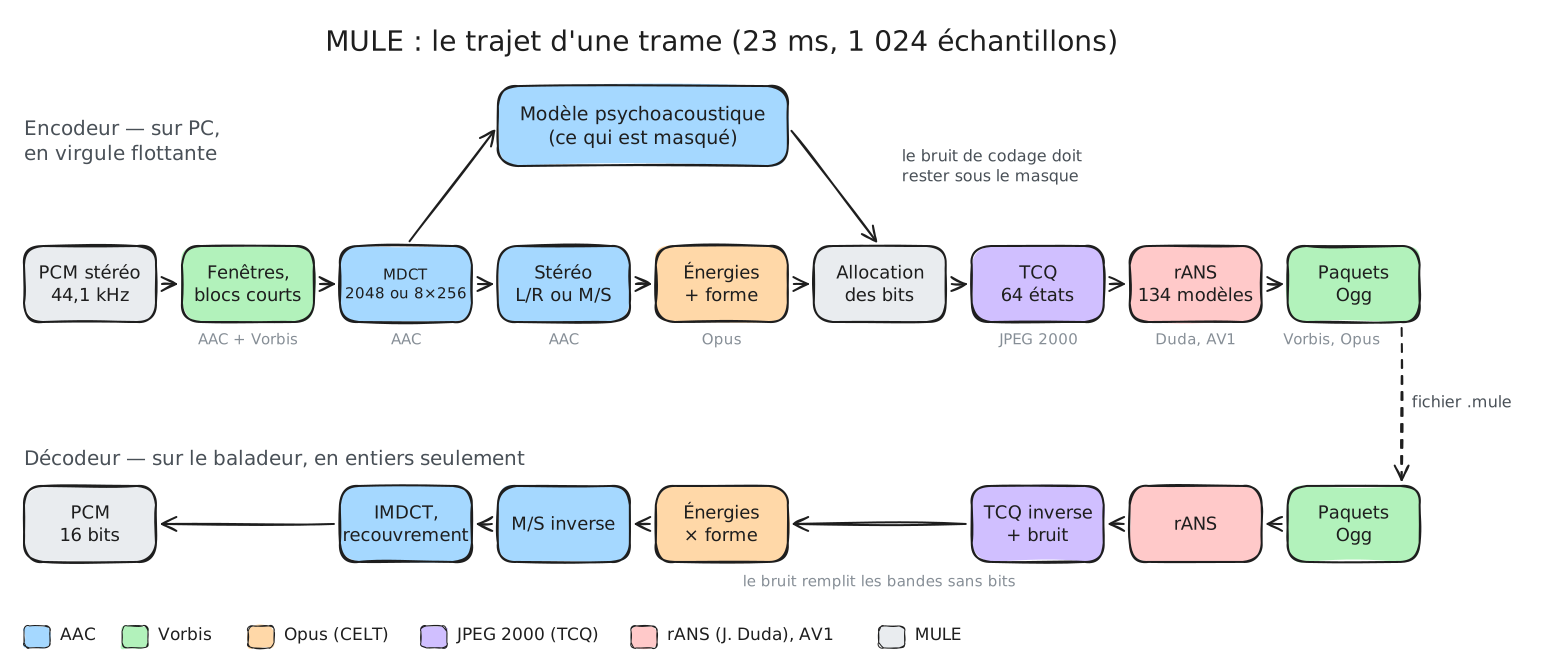
La figure 1 montre la chaîne complète. Les couleurs disent d’où vient chaque brique. Rien n’y
est vraiment inventé : MULE, c’est un assemblage de bonnes idées piquées à droite et à gauche,
plus une ou deux à moi qui ne marchaient pas (j’y reviendrai dans le cinquième billet, qui
s’appellera, sans surprise, « Le cimetière des bonnes idées »).
Découpage : trames et fenêtres
Le besoin
Une piste audio ne se code pas d’un bloc. On la découpe en trames, et on analyse chaque
trame avec un peu de ses voisines : les analyses se recouvrent. Avant d’analyser, on multiplie
le bloc par une fenêtre qui monte en douceur puis redescend, plutôt qu’une fenêtre carrée
qui créerait des distorsions aux jonctions.
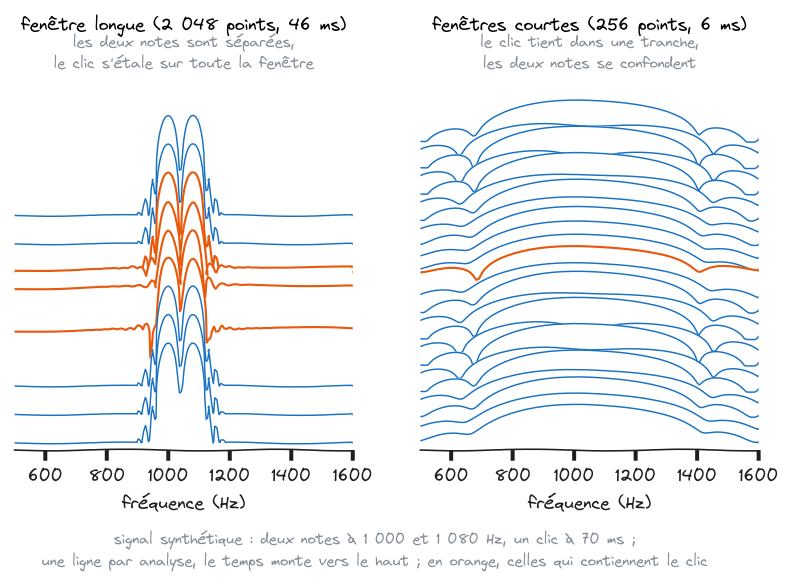
Reste à choisir la taille, et là, pas de miracle. La théorie du signal le dit : on ne peut pas
être précis à la fois en temps et en fréquence. Une fenêtre longue distingue très bien deux
fréquences voisines, ce qui est parfait pour une note de violon tenue. Mais elle étale dans le
temps tout ce qui se passe à l’intérieur.
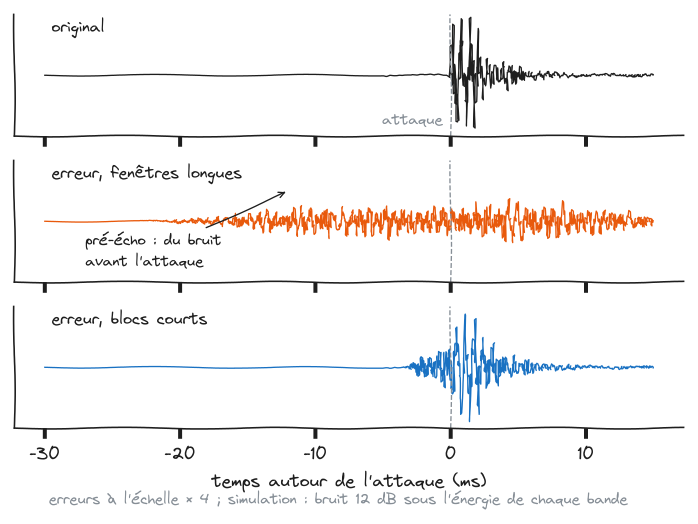
Prenez une castagnette. Le claquement dure quelques millisecondes ; juste avant, il y a du
silence. Si on code ce bloc en fenêtre longue, le bruit de quantification s’étale sur toute la
fenêtre, y compris sur le silence qui précède l’attaque. Et ce bruit-là, aucun son ne le
masque : on entend un petit souffle avant le coup, comme un écho qui serait arrivé en avance.
C’est le pré-écho, le principal défaut des codecs à transformée. Il faut donc pouvoir
changer de taille de fenêtre quand une attaque arrive, et un détecteur pour savoir quand.
Ce que font les autres
- MP3 : des granules de 576 échantillons, et des blocs courts trois fois plus petits pour
les attaques. Sa transformée est un hybride bizarre, on en reparle juste après.
- AAC : des trames de 1 024 échantillons analysées sur 2 048, et huit blocs courts de
256 pour les attaques. Les blocs courts sont groupés : ceux qui se ressemblent partagent
leurs informations, ce qui évite de tout payer huit fois.
- Vorbis : deux tailles par fichier, choisies par l’encodeur parmi les puissances de deux de
64 à 8 192. À 44,1 kHz, libvorbis prend 256 et 2 048, la même géométrie qu’AAC. Sa fenêtre
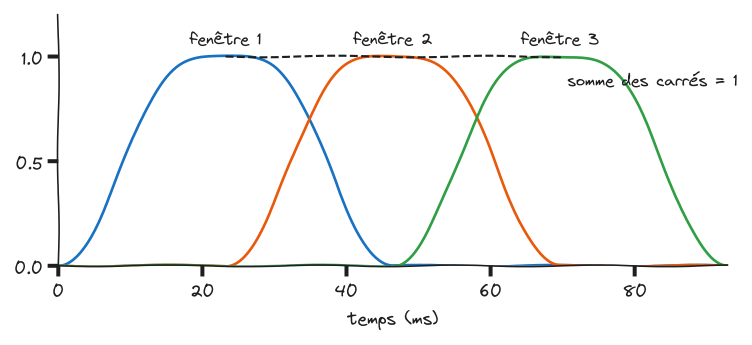
est « à puissance complémentaire » : quand on additionne deux fenêtres voisines au carré, on
retombe exactement sur 1.
- Opus : des trames de 2,5 à 20 ms, à 48 kHz seulement, avec un recouvrement très court
(2,5 ms) pour réduire la latence de la visioconférence. Pour les attaques, il découpe la trame
en MDCT plus courtes, puis peut rendre de la finesse en fréquence bande par bande. Ses tailles
ne sont pas des puissances de deux (960 échantillons à 20 ms).
Le choix de MULE, et pourquoi
Des trames de 1 024 échantillons (23,2 ms à 44,1 kHz), analysées sur 2 048, et huit blocs
courts de 256 pour les attaques, groupés comme dans AAC. La fenêtre est celle de Vorbis.
- Pas de contrainte de latence : un baladeur qui lit un fichier se moque d’avoir 23 ms de
retard. Une grande trame avec un grand recouvrement, c’est la meilleure finesse en fréquence
pour la musique tenue.
- 44,1 kHz natif : le DAC de l’Echo Mini tourne à 44,1 kHz, donc pas de rééchantillonnage
comme avec Opus. (48 kHz, c’est la fréquence choisie pour se caler sur la vidéo : cela
donne un nombre entier d’échantillons par image, y compris à 24 images par seconde, la
cadence du cinéma ; le CD est resté à 44,1)
- Des puissances de deux : c’est ce que l’accélérateur hardware sait faire pour le AAC.
- Une géométrie éprouvée : AAC et libvorbis tombent sur les mêmes tailles, ce n’est pas un
hasard.
- Le codec fonctionnant à fréquence fixe (44,1 kHz), on n’a pas besoin de supporter d’autres tailles
de trames pour les autres fréquences.
Reste à savoir quand basculer en blocs courts. MULE utilise un détecteur de transitoires très
simple : il filtre le signal au-dessus de 3 kHz (en dessous, il n’y a pas vraiment d’attaques
nettes), mesure son énergie par paquets de 128 échantillons, et crie « attaque ! » quand elle
saute de 10 dB. Simple, mais plus efficace que tous les autres systèmes testés.
J’ai passé un temps déraisonnable à essayer d’améliorer ce point (parce que les outils
d’évaluation psychoacoustique pèsent lourdement les attaques) : modulation du bruit, détecteurs
plus malins, plus de bits pour les blocs courts, plus de blocs courts… Presque tout a fini à la
poubelle. Plus de blocs courts, en particulier, fait baisser la note. Le système le plus
efficace était le plus simple, une borne héritée d’AAC : le masque d’une trame longue n’a pas
le droit de monter de plus de 10 dB par rapport à la trame précédente.
Et pourquoi pas plus de tailles ? Un bloc intermédiaire de 512 n’a pas été essayé directement,
mais il a été écarté par ricochet : ajouter de la résolution temporelle (plus de blocs courts)
fait baisser la note, et un troisième type de bloc demande des fenêtres de transition en plus.
Des trames de 4 096 ? L’accélérateur ne les prend pas en charge, et elles doubleraient les
tampons du décodeur, sur un cœur B qui compte ses octets. Vorbis les autorise (jusqu’à 8 192),
mais à 44,1 kHz, libvorbis s’en tient à 256 et 2 048.
Passer en fréquences : la MDCT
Le besoin
Une transformée qui passe du temps aux fréquences et qui coche quatre cases : des nombres réels
(pas de complexes à stocker), autant de coefficients que d’échantillons nouveaux (pas un de
plus à coder), une reconstruction parfaite malgré le recouvrement (pas de clic aux jonctions),
et un calcul rapide.
Il faut aussi regrouper les coefficients en bandes, parce que l’oreille ne traite pas les
fréquences une par une. Elle sépare finement deux notes graves, et beaucoup moins finement deux
sifflements aigus. Les acousticiens mesurent ce découpage en Bark, ou bandes critiques.
Ce que font les autres
- MP3 fait les choses en deux temps : un banc de 32 filtres hérité du MP2, puis une MDCT dans
chaque sous-bande. C’est un compromis historique (garder la compatibilité avec le MP2), et
une source connue de défauts.
- AAC, Vorbis et CELT utilisent une MDCT pure (Modified Discrete Cosine Transform).
- Pour les bandes : MP3 a une vingtaine de bandes de facteurs d’échelle, AAC 49 en trame longue
à 44,1 kHz. Vorbis décrit l’enveloppe du spectre par une courbe en segments (le floor).
CELT utilise 21 bandes calquées sur les Bark.
Le choix de MULE, et pourquoi
Une MDCT pure, comme AAC, Vorbis et CELT. Elle prend 2 048 échantillons et en sort 1 024
coefficients, un par « raie » de fréquence, espacées de 21,5 Hz.
Une raie, c’est l’un de ces coefficients : un nombre qui dit combien il y a de son autour
d’une fréquence précise. La raie 0 couvre les fréquences de 0 à 21,5 Hz, la raie 1 de 21,5 à
43 Hz, et ainsi de suite jusqu’à la raie 1 023, vers 22 kHz. Dessinées côte à côte, elles
forment un peigne : une note y apparaît comme une série de pics, un par harmonique (figure 5),
et un bruit comme une herbe drue, partout sur le graphique. Une note pure n’allume pas une
seule raie, mais deux ou trois voisines. Si on avait une résolution infinie en fréquence, il
n’y aurait qu’un pic, à la fréquence exacte. Avec une fenêtre de 46 ms, chaque note s’étale
un peu sur ses voisines.
Le terme vient de la spectroscopie, où chaque couleur présente dans une lumière dessine
une raie sur le spectre. Et 21,5 Hz, c’est 44 100 / 2 048 : plus la fenêtre est longue,
plus les raies sont serrées, c’est tout le dilemme de la figure 3.
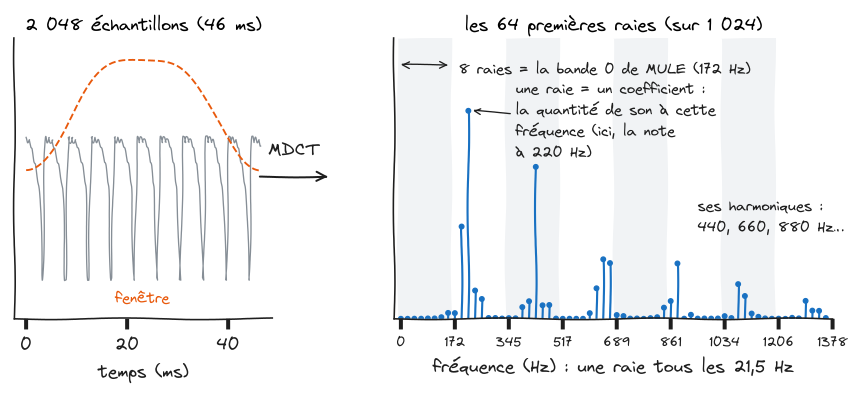
Revenons à nos échantillons 2 048 en entrée, 1 024 en sortie. On perd la moitié de l’information
à chaque bloc. Le miracle, c’est que cette perte est rattrapée par le recouvrement : les
erreurs qu’introduit un bloc sont exactement annulées par celles, opposées, du bloc voisin.
Les spécialistes appellent ça le TDAC (Time-Domain Aliasing Cancellation).
Pourquoi recouvrir à 50 % ? Si on codait des blocs bord à bord, chacun aurait son propre bruit
de quantification, et ce bruit changerait brutalement à chaque jonction : un petit clic toutes
les 23 ms. En recouvrant les blocs de moitié, avec une fenêtre qui monte et descend en douceur,
on passe d’un bloc à l’autre en fondu. Des gens plus malins que moi ont trouvé la condition que
doit remplir la fenêtre pour que la reconstruction reste parfaite (la somme des carrés qui vaut
1, figure 2) : c’est pour ça qu’on n’utilise pas une fenêtre carrée.
Pourquoi pas une bonne vieille FFT (Fast Fourier Transform) ? Elle donne des nombres
complexes, avec une partie réelle et une partie imaginaire. Avec un recouvrement de moitié, on
coderait deux fois plus de nombres qu’il n’y a d’échantillons. La MDCT recouvre sans rien coder
en double. Bonus pour mon baladeur : une
MDCT se calcule avec une FFT quatre fois plus petite (512 points pour une fenêtre de 2 048), et
cette FFT, l’accélérateur de l’Echo Mini sait la faire.
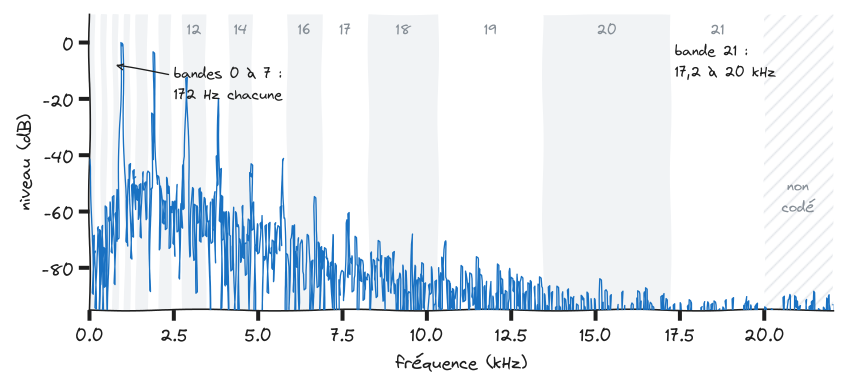
Le spectre est découpé en 22 bandes de largeurs inégales : très étroites dans les graves
(8 raies, soit 172 Hz), larges dans les aigus (jusqu’à quelques kHz). C’est proche des 21 bandes
de CELT : à peu près une bande par Bark dans les médiums, et assez peu de bandes pour que leurs
informations (énergie, allocation) coûtent peu.
Encadré : pourquoi les bandes d’Opus, et pas celles de Vorbis ?
Vorbis laisse l’encodeur choisir sa géométrie : la position des points de son enveloppe (le
floor) et le découpage du résidu sont décrits dans l’en-tête de chaque fichier. C’est
souple, et c’est exactement ce qui coûte cher sur l’Echo Mini : il faut charger ces
descriptions en RAM avant de décoder la première trame. MULE fige sa grille, celle de CELT,
dans le décodeur : 24 entiers, en ROM.
Une grille fixe a deux autres avantages. Les modèles de probabilité sont rattachés aux bandes
(une bande grave ne se comporte pas comme une bande aiguë), et leurs tables de départ sont
apprises une fois pour toutes sur un corpus ; si la géométrie changeait d’un fichier à
l’autre, il n’y aurait rien de stable à apprendre. Et la grille se compte en unités de
8 raies : en blocs courts, une unité vaut une raie par fenêtre, si bien qu’une bande a le
même nombre de coefficients en trame longue et en trame courte, et partage ses tables.
C’est aussi pour cela que les bandes ne sont pas exactement calées sur l’échelle de Bark.
Vorbis lui-même a abandonné son premier floor (floor 0) pour une version plus simple
(floor 1), et le mécanisme n’a été repris ni par Opus, ni par aucun autre codec grand public.
La finesse que Vorbis s’offre avec sa géométrie, MULE la récupère côté encodeur, en utilisant
des masques calculés à l’échelle de la raie dans les graves : ils donnent de la résolution là
où elle compte, sans rien changer au format. Des bandes plus fines dans les aigus n’auraient pas aidé, puisque le bruit
de MULE y est déjà sous celui d’Opus, et changer leur résolution dans le temps a rapporté
+0,003 d’ODG. Autant dire rien.
Le besoin
Dans chaque bande, il faut transmettre le niveau (combien d’énergie) et le détail (comment cette
énergie se répartit entre les raies). Et l’oreille ne pardonne pas les mêmes choses aux deux. Si
le détail est grossier (les raies un peu à côté de leur vraie valeur), ça passe souvent
inaperçu, surtout dans les aigus. Mais si l’énergie d’une bande est fausse (un trou, une
bosse), ça s’entend tout de suite : le timbre change, le son devient « creux » ou
« métallique ». C’est la même chose pour la compression d’image, si la teinte est un peu grossière
cela ne se voit presque pas, alors qu’un défaut de luminosité ou de contraste saute aux yeux.
Ce que font les autres
- MP3 et AAC ne codent pas l’énergie. Ils transmettent un facteur d’échelle par bande,
c’est-à-dire un pas de quantification, et l’énergie est ce qui reste après l’arrondi. Une
bande quantifiée trop grossièrement tombe à zéro, et on entend des trous qui clignotent : les
fameux « birdies » des MP3 à bas débit.
- Vorbis code d’abord l’enveloppe (le floor), puis le détail divisé par cette enveloppe
(le residue), avec ses codebooks. L’esprit est proche.
- Opus (CELT) pousse l’idée au bout : il code l’énergie de chaque bande (par pas de
6 dB, affinés ensuite), puis une forme de longueur exactement 1, avec la PVQ. Au décodage,
forme × énergie donne exactement l’énergie transmise, quelle que soit la précision de la
forme.
Le choix de MULE, et pourquoi
L’énergie à part, comme CELT, mais une forme quantifiée simplement, sans PVQ. Dans chaque
bande, MULE code :
- l’énergie de la bande, par pas de 1,5 dB ;
- la forme : les coefficients divisés par cette énergie, puis arrondis avec un pas propre à
la bande (l’allocation, on y vient).
Le niveau de la bande est donc toujours juste à 1,5 dB près, et l’arrondi de la forme se fait
autour de ce niveau, pas à sa place. Je n’impose pas la longueur 1 comme CELT : c’est ce qui
permet de se passer de la PVQ, que je ne comprenais pas, et d’utiliser un quantificateur
scalaire, bien plus simple (et en treillis, voir plus bas). J’ai quand même codé une PVQ pour
comparer : elle perdait, surtout sur les sons tonals.
Ces énergies coûtent peu, parce qu’elles sont prévisibles : une bande ressemble à la même bande
dans la trame précédente, et à sa voisine du dessous. MULE ne code que l’écart à cette
prédiction. Le troisième billet racontera comment on grappille les bits là-dessus.
Encadré : et si une bande n’a droit à aucun bit ?
Ça arrive quand le bruit qu’on a le droit d’ajouter dans une bande dépasse l’énergie de la
bande elle-même. Autrement dit, on pourrait remplacer tout son contenu par du bruit au même
niveau sans que l’oreille s’en aperçoive : coder sa forme ne servirait à rien. Ce sont surtout
des bandes dont le signal ressemble déjà à un bruit blanc (une cymbale, le souffle d’un
enregistrement, l’extrême aigu) : un bruit masque bien mieux qu’un son pur, et l’oreille
entend de moins en moins au-dessus de 16 kHz. Une bande tonale n’y tombe presque jamais :
remplacer une note par du bruit, ça s’entend. Mais laisser la bande vide créerait un trou dans
le spectre, et un trou, ça s’entend aussi.
- MP3 laisse le trou.
- AAC peut remplacer une bande par du bruit, si l’encodeur le signale (le PNS), et ses
versions récentes remplissent les zéros de bruit (noise filling).
- Opus recopie dans la bande vide un morceau du spectre des bandes plus basses (le
pliage, ou folding), puis le remet au bon niveau.
MULE remplit la bande de bruit, mis exactement au niveau de l’énergie transmise. Pas de
pliage : à 128 kb/s, MULE n’a presque besoin de bruit qu’au-dessus de 16 kHz, où le pliage
n’apporterait rien d’audible. C’est bluffant de voir à quel point l’oreille se contente d’un
bruit au bon niveau dans les aigus.
Le masque psychoacoustique
Le besoin
Depuis le début de l’article on parle de masque sans vraiment expliquer ce que c’est.
Tout ce qui précède, c’est de la plomberie. Le modèle psychoacoustique, c’est le modèle perceptif.
Son travail : pour chaque bande de chaque trame, dire combien de bruit on peut ajouter sans que
personne ne s’en rende compte ou à quel point on peut dégrader le signal dans cette zone sans
que cela ne soit audible.
Il repose d’abord sur le masquage simultané. Un son fort rend inaudibles les sons plus
faibles de fréquence voisine. Une grosse caisse noie le petit bruit de fond dans les graves ;
une cymbale cache une foule de détails dans les aigus. Ce masquage déborde de part et d’autre
de la fréquence du son masquant, avec une pente asymétrique : il s’étend plus vers les aigus
que vers les graves.
Ensuite vient la tonalité. Un son pur masque moins bien qu’un bruit de même énergie :
l’oreille repère facilement un petit bruit parasite à côté d’une flûte, beaucoup moins à côté
d’une cymbale.
Enfin, il y a le seuil absolu d’audition : en dessous d’un certain niveau, on n’entend rien
du tout, masque ou pas.
Ce que font les autres
- MP3 et AAC : la norme décrit deux modèles, dits 1 et 2, mais seulement à titre
d’exemple : le modèle psychoacoustique n’est pas normatif, chaque encodeur fait ce qu’il veut.
LAME, l’encodeur MP3 libre, a le sien, réglé à l’oreille pendant des années.
- Vorbis : un modèle dans l’encodeur, avec des courbes de masquage différentes pour les sons
tonals et pour le bruit.
- Opus n’a pas de masque explicite. C’est la conservation de l’énergie par bande, une table
d’allocation fixe et quelques coups de pouce de l’encodeur qui en tiennent lieu.
Le choix de MULE, et pourquoi
Un masque explicite, calculé bande par bande, dans la tradition d’AAC. Le débordement d’une
bande sur l’autre suit la fonction d’étalement classique de Schroeder, qui date de 1979. Rien de
neuf sous le soleil. La tonalité se mesure par la « platitude » du spectre de chaque bande :
plate, c’est du bruit ; avec un pic net, c’est un son tonal. Selon le cas, le seuil de masquage
est placé 5,5 dB sous l’énergie (bruit) ou bien plus bas, jusqu’à 25 dB (tonal).
Pourquoi un masque explicite plutôt que la méthode d’Opus ? Parce que dans MULE, c’est
l’encodeur qui décide de tout et le décodeur qui obéit. Un masque explicite se règle, se mesure
et s’améliore sans toucher au format. Après le gel du format v2, tous les gains de qualité sont
venus de l’encodeur (masque et allocation), sans changer une ligne du décodeur.
Ça, c’est la théorie savante. Dans la pratique, le modèle a eu besoin de quelques rustines
empiriques, et ce sont elles qui ont fait la différence :
- +10 dB de marge dans les 8 premières bandes, sous 1,4 kHz, et un peu de marge dans les
médiums. Les modèles classiques sont trop optimistes dans les graves.
- Des masques calculés raie par raie dans les graves, au lieu d’un masque par bande. En
dessous de 2 kHz, une seule bande couvre presque 2 Bark, et un masque calculé sur toute la
bande laissait passer du bruit autour des notes graves isolées. Cette correction-là a rapporté
jusqu’à +0,2 point sur la note de qualité d’un orchestre et d’un extrait de triangles.
C’est énorme, à l’échelle de ce projet.
- La borne de pré-écho empruntée à AAC et évoquée plus haut.
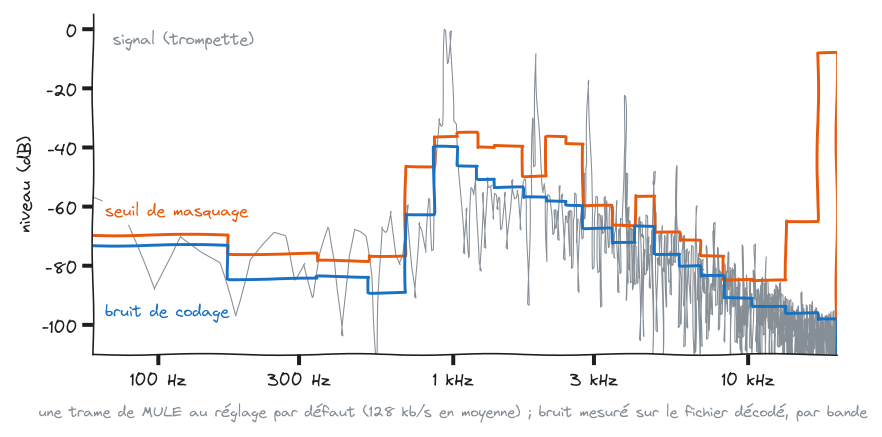
La figure 7 résume tout le billet. Si vous ne deviez en retenir qu’une phrase, ce serait
celle-ci : l’encodeur ne cherche pas à reproduire le signal, il cherche à cacher son
erreur. Le bruit de codage est là, partout, mais il épouse la forme du masque, toujours un peu
en dessous.
J’ai évidemment essayé de faire mieux : le modèle 2 de MPEG (qui mesure la tonalité autrement),
l’étalement de Terhardt, l’addition des masques en loi de puissance, et récemment le masquage
temporel. Tout a fini au cimetière, et le cinquième billet racontera pourquoi. Le modèle actuel
n’a rien de révolutionnaire. Il est juste bien réglé.
Distribuer les bits : l’allocation
Le besoin
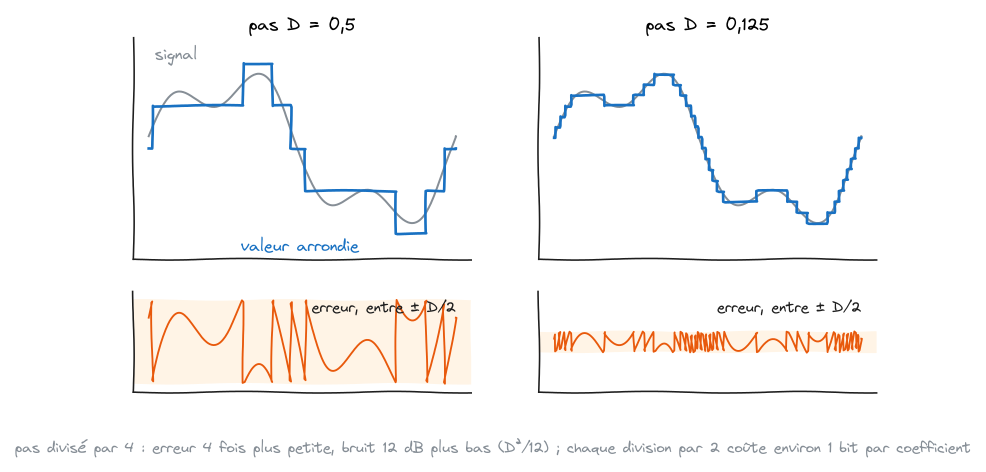
Le masque dit combien de bruit chaque bande peut supporter. Reste à traduire ça en bits. Le
bruit de quantification dépend du pas : si on arrondit au multiple de D le plus proche,
l’erreur moyenne vaut à peu près D²/12. Il faut donc choisir un pas par bande, et décider
comment le budget se répartit d’une trame à l’autre.
Ce que font les autres
- MP3 et AAC cherchent les pas par une double boucle : une boucle sur le gain global pour
tenir le débit, une boucle sur les facteurs d’échelle pour repousser le bruit sous le masque.
Ils visent souvent un débit constant, lissé par un « réservoir de bits ».
- Vorbis travaille surtout en qualité constante (le
-q d’oggenc), le débit suit.
- Opus a une approche originale : l’allocation n’est pas transmise. Le décodeur la
recalcule lui-même à partir du budget de la trame et d’une table fixe ; l’encodeur n’envoie
que quelques ajustements. Peu d’informations à transmettre, mais moins de liberté pour
l’encodeur.
Le choix de MULE, et pourquoi
Une allocation explicite par bande, tirée du masque, puis ajustée en comptant les vrais
bits ; et un débit variable à qualité constante.
Pour chaque bande, MULE choisit le pas qui met le bruit exactement au niveau du masque,
multiplié par un réglage global de qualité. Ce pas est transmis sous forme d’« allocation », un
entier : une unité de plus, c’est un pas plus fin de 1,5 dB, donc un peu plus de précision et un
peu plus de bits. Le coût est faible, parce que l’allocation d’une bande ressemble à celle de sa
voisine ou de la trame précédente. En échange, l’encodeur est libre : c’est lui qui décide, et
il peut progresser sans toucher au décodeur. Si vous ne l’avez pas encore compris, porter le
décodeur pour l’Echo Mini, mettre à jour le firmware et effectuer les tests est excessivement
répétitif et fatiguant. Mettre à jour et tester des évolutions de l’encodeur peut être fait de
manière très automatisée avec Python et Claude Code.
Ensuite vient la quantification proprement dite. MULE n’arrondit pas bêtement chaque
coefficient : il utilise une quantification en treillis (TCQ), une technique empruntée à
JPEG 2000 qui divise le pas par deux sans payer le bit supplémentaire. C’est le gain le plus
important du projet, et ça mérite un billet entier, le deuxième. Pour l’instant, retenez juste
qu’elle existe et qu’elle est géniale.
Le calcul « pas idéal = masque » est un point de départ, pas une vérité. Parfois, une allocation
d’une unité plus faible coûte beaucoup moins de bits pour un bruit à peine plus fort ; parfois,
c’est l’inverse. L’encodeur essaie donc, pour chaque bande, l’allocation calculée et ses deux
voisines, et garde celle qui minimise « bruit + λ × bits ». C’est le compromis
débit-distorsion, la même idée que dans les encodeurs vidéo. λ dit combien un bit vaut en
bruit. Et MULE compte les vrais bits, avec les mêmes modèles de probabilité que le codeur
entropique qui viendra juste après.
Dernière chose : MULE est un codec à débit variable. Chaque trame vise la même qualité
perçue, c’est-à-dire le même rapport entre bruit et masque, et prend les bits dont elle a besoin.
Un passage calme coûte peu, une batterie saturée coûte cher. Le réservoir de bits d’AAC n’a pas
de sens ici : on encode un fichier, personne n’attend un débit constant. J’ai testé des
stratégies plus complexes : plus de bits aux attaques, ou aux trames les plus « difficiles ».
Rien ne fait mieux que cette règle simple.
C’était prévu théoriquement et c’est le mode de fonctionnement de Vorbis; je l’ai vérifié
quand même, parce que je suis têtu. Comme une mule (et parce que c’est Claude qui a fait le
boulot).
La stéréo : deux canaux pour le prix d’un et demi
Le besoin
La gauche et la droite d’un morceau se ressemblent énormément : la voix est au milieu, la
basse aussi, souvent la batterie. Coder les deux canaux séparément, c’est payer deux fois la
même information.
Ce que font les autres
La parade classique est le codage M/S : au lieu de gauche et droite, on code le milieu
(M, la somme) et le côté (S, la différence). Quand les deux canaux se ressemblent, S est
presque nul et ne coûte presque rien.
- MP3 choisit L/R ou M/S pour toute la trame.
- AAC choisit bande par bande.
- Vorbis utilise un couplage « polaire » sans perte, et à bas débit une stéréo simplifiée
dans les aigus.
- Opus code M et S avec un angle par bande qui règle leur part respective.
Pour les bas débits, AAC et Opus ont aussi la stéréo d’intensité : dans les aigus, on ne
code qu’un canal et un angle, et le décodeur reconstruit la stéréo.
Le choix de MULE, et pourquoi
L/R ou M/S, bande par bande et trame par trame, comme AAC. Pour chaque bande, l’encodeur
estime ce que coûteraient les deux représentations, en « entropie perceptuelle » (grossièrement,
le nombre de bits qu’il faudrait pour rester sous le masque), et prend la moins chère. Sur mon
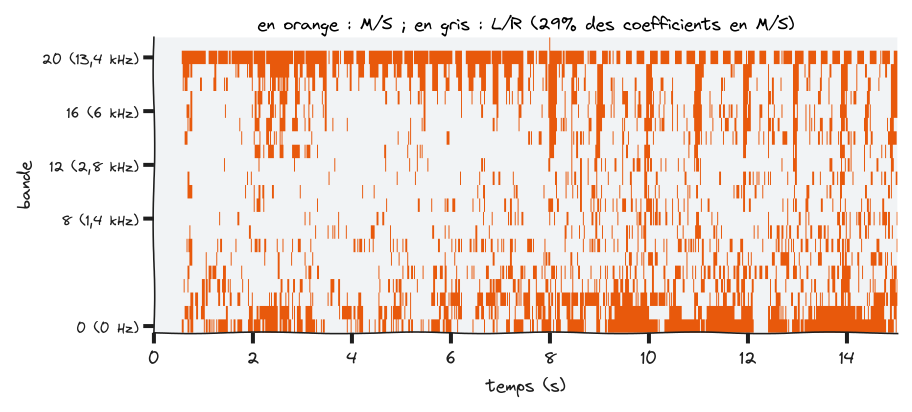
corpus de réglage, environ 41 % des coefficients finissent en M/S.
Pas d’intensité : je l’ai évaluée pour MULE, et à 128 kb/s elle rapporterait au mieux 2 à 3 %
de débit, au prix d’une image stéréo dégradée. Opus lui-même la réserve aux bas débits. Pas
d’angle à la Opus non plus : une rotation par bande, mesurée, rapportait 0,16 % de débit.
L’angle d’Opus découle de sa construction énergie/forme : comme M et S ont chacun une forme de
longueur 1, il faut bien dire comment l’énergie se partage entre eux.
Mettre en boîte : codage entropique et conteneur
Le besoin
À ce stade, la trame est devenue une suite de petits nombres : le type de bloc, les choix
stéréo, les énergies, les allocations, les coefficients quantifiés et leurs signes. Il reste à
les écrire avec le moins de bits possible : c’est le travail du codeur entropique. Un symbole
fréquent doit coûter une fraction de bit ; un symbole rare en coûte plusieurs. Puis il faut
ranger les trames dans un fichier, et pouvoir sauter n’importe où dedans.
Ce que font les autres
- MP3 et AAC : des tables de Huffman fixes, gravées dans la norme.
- Vorbis : du Huffman aussi, mais les tables (les codebooks) sont dans l’en-tête de chaque
fichier. Souple, mais il faut les charger en RAM.
- Opus : un codeur arithmétique (range coder), avec des probabilités fixes.
- AV1, le codec vidéo, utilise un codeur arithmétique dont les probabilités s’adaptent
au fil du flux.
- Côté conteneur, le MP3 aligne ses trames à la suite, AAC vit dans du MP4 (ou de l’ADTS), Vorbis
et Opus dans de l’Ogg.
Pour Vorbis, en théorie, l’encodeur pourrait générer des tables de Huffman propres à chaque piste.
Dans les faits, chaque encodeur réutilise un jeu de tables prédéfini en fonction des paramètres.
Toutes les pistes d’un même album utilisent les mêmes tables. L’intérêt de mettre les tables
dans le fichier, c’est qu’on peut changer l’encodeur sans toucher au décodeur.
Le choix de MULE, et pourquoi
Un codeur rANS (une variante de l’Asymmetric Numeral System de Jarek Duda) et
134 modèles de probabilité qui s’adaptent au fil du morceau, à la manière d’AV1. Les tables
de départ sont apprises sur un corpus et tiennent dans le décodeur : rien à charger par fichier,
contrairement à Vorbis. Le décodeur rANS se réduit à quelques multiplications et décalages
entiers, ce qui convient parfaitement à un Cortex-M3. C’est là que se gagne une énorme partie
de la compression : sans codeur entropique, le même flux pèserait plus du double. Le troisième
billet lui sera consacré.
Les trames sont groupées par paquets de 4. Toutes les 40 trames (0,93 s), un paquet clé
remet les modèles de probabilité à zéro : c’est ce qui permet de sauter n’importe où dans un
morceau sans tout décoder depuis le début. Les paquets sont rangés dans un conteneur Ogg,
exactement comme Vorbis et Opus. Le lecteur de l’Echo Mini et la plupart des firmwares alternatifs
savent lire les conteneurs Ogg, et Ogg apporte gratuitement les métadonnées et la
lecture sans blanc entre les pistes d’un album live. Merci Xiph.
Le décodeur, en miroir
Le besoin
Le décodeur doit refaire, dans l’ordre inverse, tout ce que l’encodeur a écrit : lire les
symboles, reconstruire les coefficients, défaire la stéréo, revenir dans le domaine temporel
et recoller les fenêtres. Il doit être petit, rapide, et surtout donner partout le même son.
Ce que font les autres
Ce que dit la norme, et ce que tolère la conformité, varie beaucoup :
- MP3 et AAC acceptent une petite erreur par rapport au décodeur de référence.
- Opus fournit une version en virgule fixe officielle, et vérifie la conformité avec un
seuil de qualité, pas au bit près.
- Tremor, l’implémentation officielle de Vorbis en virgule fixe ne sort pas les mêmes échantillons que libvorbis.
C’est super casse-pieds quand vous devez évaluer la qualité d’un décodeur au hasard parce que vous
devez le porter sur un lecteur de musique portable qui comporte des accélérateurs matériels pas super
bien documentés et qui font des arrondis en interne.
Le choix de MULE, et pourquoi
Un décodeur virgule fixe uniquement, dont la sortie est normative au bit près. Il ne réfléchit
pas : il lit. Pas de modèle psychoacoustique, aucune décision à prendre. Il décode les symboles,
reconstruit les coefficients (en remplissant de bruit les bandes sans bits), défait le M/S,
applique la MDCT inverse et recolle les fenêtres.
D’où une asymétrie énorme. L’encodeur, en virgule flottante, avec son Viterbi et ses
allers-retours débit-distorsion, tourne quatre à six fois plus vite que le temps réel sur un
PC. Le décodeur tourne sur le baladeur à environ 59 MHz en moyenne, dans 30 Kio de code et
de tables, sans jamais toucher un nombre à virgule flottante. Tout est en entiers, et la sortie est
identique au bit près sur le PC, dans l’émulateur du firmware et sur le Cortex-M3. Une seule
version du décodeur à tester, et un test qui se résume à comparer deux fichiers. Ce n’était pas
évident dès le départ mais cela s’est imposé très rapidement pour ne pas devenir fou.
Alors, ça vaut quoi ?
Évidemment, la vraie question : est-ce que ça marche ? Voici MULE face aux trois codecs qu’il
pille allègrement (et deux encodeurs pour AAC), sur 30 extraits tirés au hasard de ma bibliothèque et jamais utilisés pour les réglages,
à débit égal. L’ODG est la note de PEAQ, un modèle d’écoute normalisé : 0, on n’entend pas de
différence avec l’original ; −1, c’est audible mais pas gênant. ViSQOL note de 1 à 5.
| |
ODG à 128 kb/s |
ODG à 160 kb/s |
ODG avancé, 128 / 160 |
ViSQOL à 128 kb/s |
| AAC (FDK) |
−0,54 |
−0,21 |
−0,57 / −0,27 |
4,30 |
| Vorbis |
−0,45 |
−0,16 |
−0,63 / −0,34 |
4,47 |
| AAC (Apple) |
−0,31 |
−0,02 |
−0,46 / −0,22 |
4,49 |
| Opus |
−0,12 |
0,00 |
−0,45 / −0,24 |
4,54 |
| MULE |
−0,17 |
−0,01 |
−0,36 / −0,14 |
4,61 |
L’AAC vient de FDK-AAC, l’encodeur de Fraunhofer (celui d’Android), en AAC-LC à débit constant et réglages par défaut. Sa dernière place est en partie un choix : il coupe tout au-dessus de
16 kHz environ, quand Opus, Vorbis et MULE montent à 20 kHz. Il met ses bits là où l’oreille d’un adulte les entend vraiment, et PEAQ et ViSQOL le lui font payer sans doute plus cher que vos
oreilles. Son mode à débit variable ne fait pas mieux : à débit égal, PEAQ préfère même le
débit constant.
L’encodeur AAC d’Apple, réputé le meilleur, ne tourne que sous Windows et macOS. J’ai fini par
le faire tourner sous wine, avec qaac et les bibliothèques
d’iTunes, en débit variable piloté par la qualité (TVBR). Même format, même décodeur, et un
tout autre résultat : −0,31 à 128 kb/s contre −0,54 pour FDK, et −0,02 à 160 kb/s, au niveau
d’Opus et de MULE. Sa bande passante s’adapte au débit et au morceau, de 16 à près de 20 kHz.
La preuve par l’exemple que, dans un codec, tout se joue dans l’encodeur.
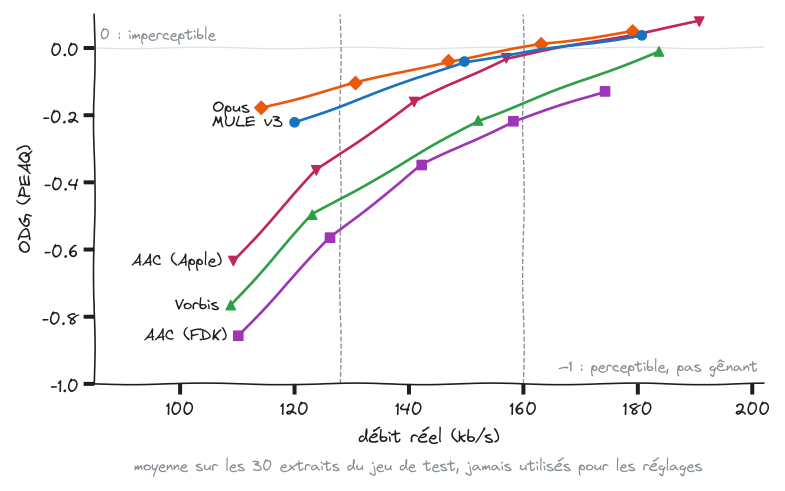
Soyons honnêtes : Opus reste devant sur la note de base de PEAQ. MULE passe devant sur la
version avancée de PEAQ et sur ViSQOL, il enterre Vorbis et FDK-AAC partout, et il reste
devant l’AAC d’Apple à 128 kb/s, avant que celui-ci ne le rattrape vers 160. Mais regardez les
écarts : on se bat pour des centièmes, dans la zone où PEAQ lui-même dit « imperceptible ». Et
en écoute à l’aveugle (16 essais par extrait, sur les six extraits où PEAQ voyait le plus grand
écart), je n’ai su distinguer MULE à 128 kb/s ni de l’original, ni d’Opus. Mes oreilles sont
probablement nulles. C’est une hypothèse sérieuse, et j’y reviendrai dans un autre billet.
Mais même les aficionados de Hydrogenaudio, sont mis en difficulté sur les tests ABX de codec
moderne comme Opus, Vorbis et AAC.
On triche : MULE ne fonctionne qu’à 44,1 kHz et en 16 bits, parce que c’est le format du CD.
Cela réduit drastiquement le nombre de paramètres à optimiser. Le code a aussi beaucoup moins
de fonctions que les autres, qui savent faire du multicanal, de la faible latence, résister aux
pertes de paquets, etc. Nous, on s’est limité à la lecture sur un baladeur.
La morale de l’histoire, c’est qu’un codec audio est constitué d’un certain nombre de briques.
Ces briques ont toutes une fonction et une raison d’être. Certaines sont relativement simples,
comme la MDCT, quasi identique dans de nombreux codecs ; d’autres relèvent de la magie noire et
des horreurs cosmiques du mythe de Cthulhu, comme la PVQ d’Opus.
Les choix de MULE ne sont pas meilleurs que ceux d’Opus : ils sont faits pour
un seul usage, sans les contraintes de latence, de réseau ou de brevets qu’Opus devait
respecter. Le génie d’Opus ou d’AAC n’est pas dans une idée géniale cachée, il est dans dix ans
de réglages, de mesures et d’écoutes. Si vous voulez un bon codec : utilisez Opus. Si vous
voulez comprendre comment fonctionne un codec, en concevoir un vous-même, même mauvais, est une
excellente école. Tout le code est sur GitHub, y compris les idées qui n’ont pas
marché, avec leurs chiffres.
Au prochain épisode : la quantification en treillis.
2026-10-31 - guiral Lacotte
The SNOWSKY ECHO MINI is a small, cheap, Chinese-made, portable music player built around a Rockchip RKNanoD (Two Cortex-M3 SoC) and two Cirrus Logic CS43131 DACs. It’s an astonishing piece of kit because the DACs are far too good compared to the rest of the components.
For the past weeks I have been writing a new firmware for it from scratch. Version 0.98, released today, turns the player into a DAC or USB sound card for the non-audio people. You plug it into a computer or your phone, and the computer’s sound comes out of the player’s headphone jack, sample for sample. Why? Because the audio circuitry and in particular the protection against electrical interference is “poor” in most consumer electronics. Using a DAC powered by its own battery helps to avoid these disturbances, whether they’re caused by your hard drives seeking or a 5,000-watt LED lighting rig with switch-mode power supplies. In my experience, this is far more important for sound quality than a lot of other audiophile ‘voodoo’ gadgets. The problem is that a high-quality DAC from a reputable brand costs at least several hundred euros.
What was supposed to be a simple implementation of an existing function – with the help of Claude Code, a bit of documentation, the SDK and other open-source implementations – turned into 22 test images and a journey down the rabbit hole to understand the device’s clock frequency drifts.
What already existed
Two firmwares already have a “USB DAC” mode:
- The stock firmware declares a USB Audio Class 1 (UAC1) device: 16 bits, 48 kHz only, an adaptive isochronous endpoint, plus a HID interface so the player’s keys act as media keys on the computer. Fine for YouTube, not so much for a FLAC library at 44.1 kHz that the computer has to resample.
- EchoPod, another custom firmware for the same player, does UAC1 at 16 or 24 bits, 44.1 or 48 kHz. Its endpoint is adaptive too, and it handles the drift between the computer’s clock and the DACs’ clock by dropping or repeating a sample when its buffer drifts too far. Simple and robust, but not bit-perfect.
Both have clocks that can drift; I’d already noticed some strange behaviour in the SoC clock. We’ll come back to that. But that’s what motivated me to implement a clock feedback.
The plan was:
- UAC1 at full speed (That means USB 1), 16 and 24 bits, 44.1 and 48 kHz in synchronous mode;
- asynchronous mode: the player keeps its own clock and tells the host how many samples to send;
- UAC2 at high speed (That means USB 2), for the higher sample rates.
USB audio 101
Audio over USB uses isochronous transfers: the host sends one packet per frame (every 1 ms at full speed, or every 125 µs “microframe” at high speed), with no retry. A packet that is missed is gone.
The difficulty is the clock. The host sends, say, 44.1 samples per millisecond on its clock; the DACs consume them on theirs. The two crystals differ by a few tens of ppm (part per million), so the buffer between them slowly fills or drains. There are two ways to deal with it:
- synchronous / adaptive: the device follows the host’s rate (adjusting its own clock, or dropping and repeating samples). The output drifts away from the original signal to make up for the frequency difference, and the clock offset itself is never corrected;
- asynchronous: the device keeps its own clock and sends the host a feedback value, “send me 44.1017 samples per frame”, on a second endpoint. The host adjusts how many samples it puts in each packet. Nothing is ever dropped or repeated: this is what “bit-perfect” means here.
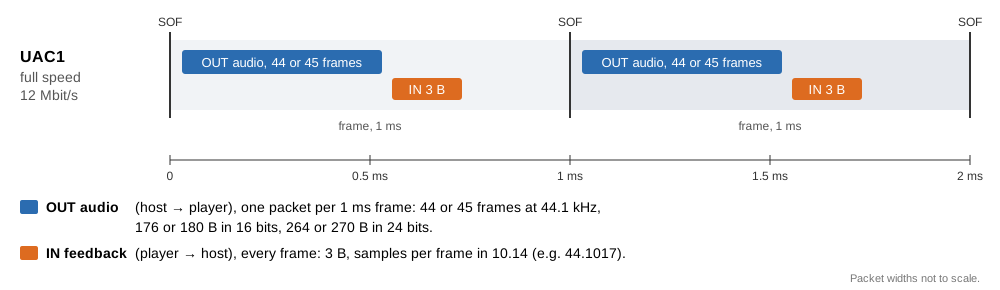 UAC1 at full speed in asynchronous mode: one audio packet and one feedback packet per 1 ms frame.
The architecture
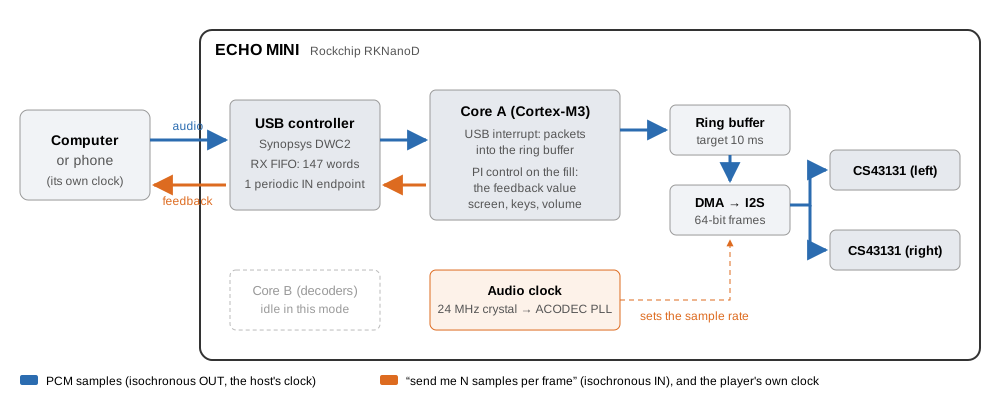 The USB sound card in the ECHO MINI: the samples come on the computer’s clock, the DACs play them on the player’s own clock, and the feedback keeps the two in step.
The USB DAC mode hands each audio packet to the main core, whose interrupt handler copies it straight into a ring buffer holding about 10 ms of PCM sound; the second core, which normally decodes files during playback, stays idle.
A DMA channel feeds the ring to the I2S port and the two CS43131 (one per channel) at a rate set by the RKNanoD’s own audio PLL, not by the USB clock.
The main core watches how full the ring is and turns that into the feedback value it sends back to the computer: that is the asynchronous mode.
If the audio source ignores the DAC’s feedback values, it is in “adaptive” mode. The DAC must figure out how to synchronize with the source’s clock by dropping or repeating audio frames.
Step 1: UAC1 at full speed (USB 1)
The USB controller is a Synopsys DWC2, which my firmware already drove for the USB disk mode. I added a generic “class” layer to the driver (descriptors, class requests, an isochronous OUT endpoint), and uac.c for the sound card itself: descriptors, the volume and sample-rate requests, and a copy of each packet straight into the DACs’ DMA ring. No codec involved, so the second core stays asleep.
The DWC2 has a specific quirk with isochronous endpoints: each one is enabled for either an even or odd frame. If a packet arrives in the wrong frame, it is ignored without warning.
It is therefore necessary to monitor and reactivate the correct parity after each packet in order to account for the possibility of an offset or an ‘incomplete isochronous OUT’ interruption.
On the device: absolutely no sound for five test images. Linux detected a sound card, packets were coming through, and DMA was working. The cause was two GPIO pins: when the USB controller started up, it configured the pins according to the requirements of USB disk mode. One of them, GPIO2_0, disabled the headphone outputs. During normal playback, this was never noticeable, as the GPIO pins are restored upon exiting USB disk mode.
Second bug: high-pitched beeps whenever the screen changed. At full speed, the endpoint must be re-armed every millisecond, and the main loop was doing it. But drawing one line of text on the screen took 1.4 ms: packets were lost, and each 1 ms hole was filled by repeated samples. The quick fix was to service the USB from inside the drawing routine, between two glyphs.
I played a whole album (29 minutes, 1.7 million packets), not one packet was lost during playback, one drift correction every 50 to 60 seconds. About 40 ppm between my PC’s clock and the Echo Mini.
After five or six attempts, I now have a sound card that works in 16 and 24-bit modes at 44.1 and 48 kHz in synchronous mode. The clock shift is inaudible. It’s encouraging, and I reckon I’ll have this sorted out soon (I’d been a bit ill and was short of sleep).
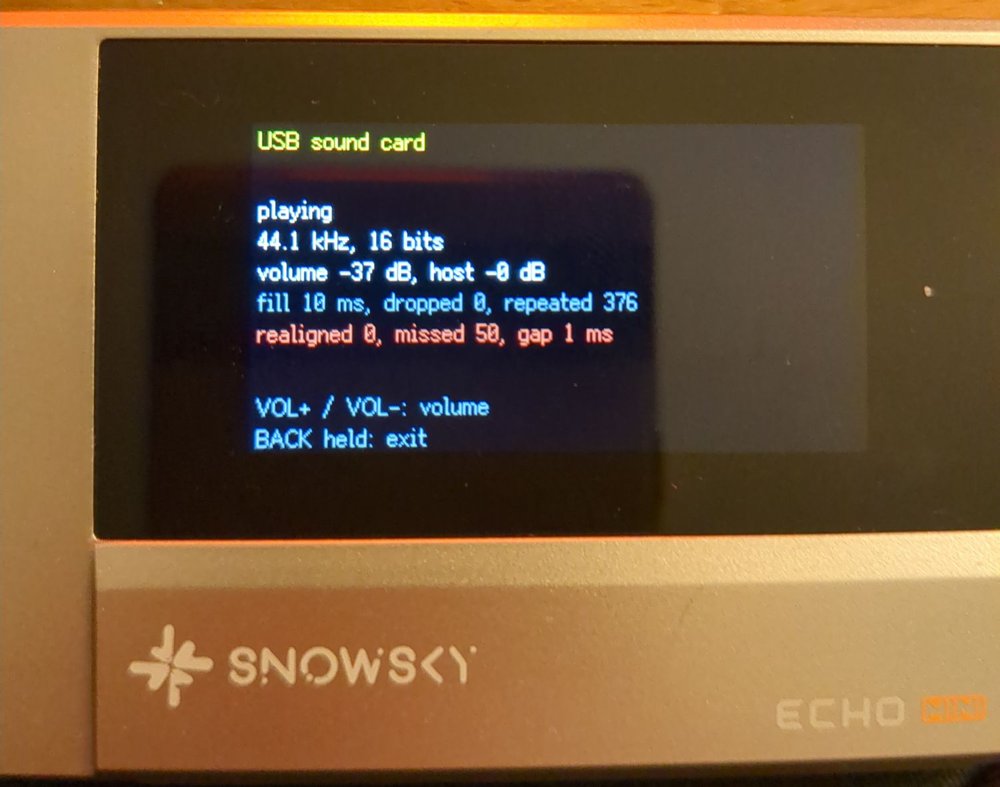 Step 1, synchronous mode at 44.1 kHz: the buffer holds 10 ms of audio, and the “repeated” counter shows the samples repeated to make up for the clock drift.
Step 2: asynchronous feedback
The feedback endpoint itself was not difficult. It’s an isochronous IN endpoint on a periodic TX FIFO. The format is a bit strange but well documented: a 3-byte value in 10.14 fixed point (samples per frame), sent every frame.
A Reminder About Fixed-Point Encoding: 10.14 means 10 bits for the integer part and 14 bits for the fractional part, for a total of 24 bits. The actual value is the received integer divided by 2¹⁴ = 16,384. In general, an m.n format has m integer bits and n fractional bits, and the value is the raw integer divided by 2ⁿ: 44.1 samples per frame is sent as:
- Integer part: 44, stored in the top 10 bits: 44 × 16,384 = 720,896.
- Fractional part: 0.1, expressed in 16,384ths: 0.1 × 16,384 = 1,638.4, rounded to 1,638.
- Total: 720,896 + 1,638 = 722,534, or 0x0B0666. This integer is stored across 3 bytes.
| |
Integer part (10 bits) |
Fractional part (14 bits) |
| Value |
44 (44 × 16,384 = 720,896) |
1,638 (1,638 / 16,384 = 0.09998) |
| Bits |
0000101100 |
00011001100110 |
Computing what to send was the difficult part. My first idea was to measure the DACs’ rate in RX/host frames. The measurements were off by 13 to 33 % and jumped around: the frame number read from the controller skiped values. The value sent to the host hit the ±1 % clock adjustment limit, the buffer drained, and the fallback repeated samples at regular intervals (beeps and static noise).
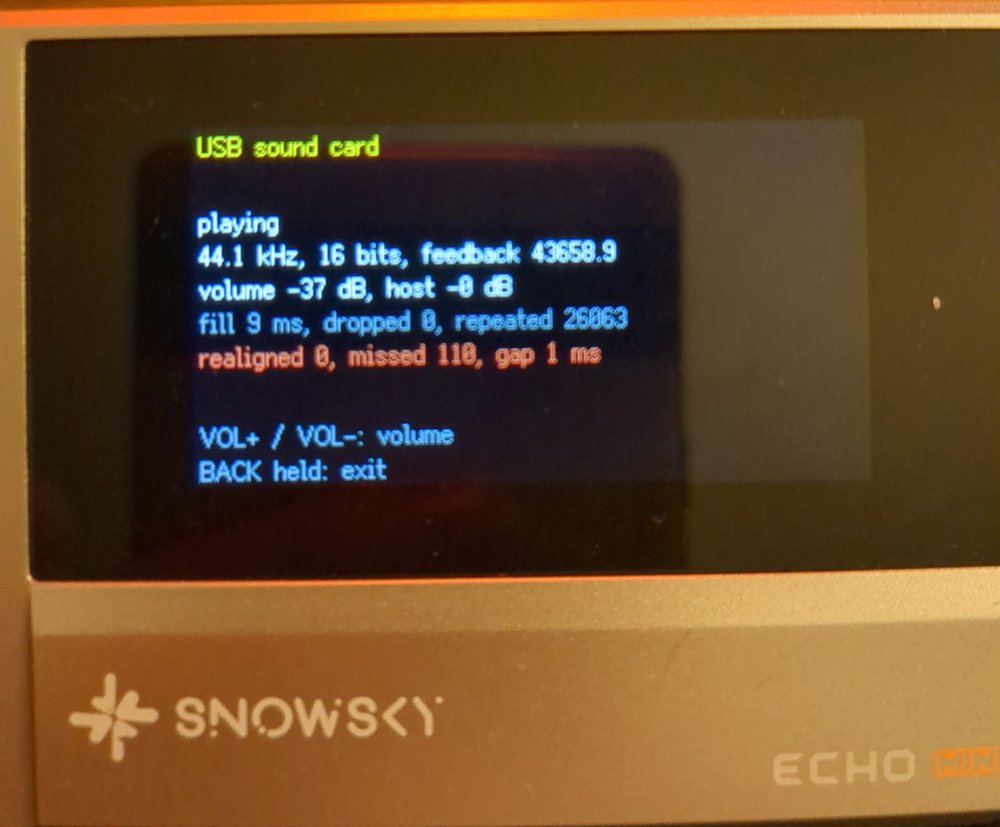 The first feedback attempt: 43,658.9 Hz is 44,100 Hz minus exactly 1 %, the limit. The host sent too little, and 26,063 samples had to be repeated.
What most asynchronous sound cards do is a control loop on the buffer’s fill level: if the ring holds more than 10 ms of audio, ask for a bit less; if it holds less, ask for a bit more. A proportional-integral controller does it (as a former automation engineer, I’m very fond of PI control). The fill is averaged over about 64 packets. I simulated it in Python for ±40 and +300 ppm before trying it on the device. The integral term ends up holding the clock difference, and the proportional term keeps the buffer on target.
On the device, Linux reported “ASYNC, Feedback Format 10.14”, and over 13 minutes of music: 760,727 packets, zero samples dropped or repeated. The feedback settled at 44,101.7 Hz, which is the same +40 ppm as before, now handled by the host.
There was also a click when entering the mode: the USB start-up toggled those two GPIOs again while the DACs were already running. The fix was to let the sound card keep the audio pins, and to always change the volume through a 3 dB / 2 ms ramp.
Yeah, I now have a sound card that works in 16 and 24-bit modes at 44.1 and 48 kHz in asynchronous mode. It’s not that difficult, it’ll all be fine. I’ll be in bed in an hour!
Step 3a: moving to the USB interrupt
At high speed, a packet can arrive every 125 µs, and no main loop that also draws a screen and polls keys can keep up with that. So before going high speed, the sound card moved to the USB controller’s interrupt (IRQ 5 on this chip): the interrupt handler receives packets, writes them to the ring, re-arms endpoints and sends the feedback. The main loop is left with the screen, the keys, the volume and the log. The drawing hacks from step 1 were removed. Same results as step 2, with about 1,900 interrupts per second, 32 µs at most.
This is a direct improvement for UAC1 mode.
Step 3b: UAC2 at high speed (USB 2)
UAC2 is a different beast from UAC1 (Change protocol; switch to USB 2). There is an interface association descriptor, a clock source entity whose sample rate the host sets, CUR and RANGE requests instead of GET_MIN/GET_MAX/GET_RES, and feedback in 16.16 format, in samples per microframe. I kept UAC1 for full-speed ports and chose the descriptors according to the speed negotiated at enumeration.
Three failed attempts:
- the feedback keeps the old sample rate after a rate change: the host reads the first feedback packets to guess their format, so the packet already queued had to be replaced at once;
- Linux ignores a feedback endpoint that does not answer at every polling interval. So no empty or skipped packets;
- one audio packet every microframe resulted in the loss of half of the packets. Switching to one packet every 4 micro-frames (500 µs) resolved the problem.
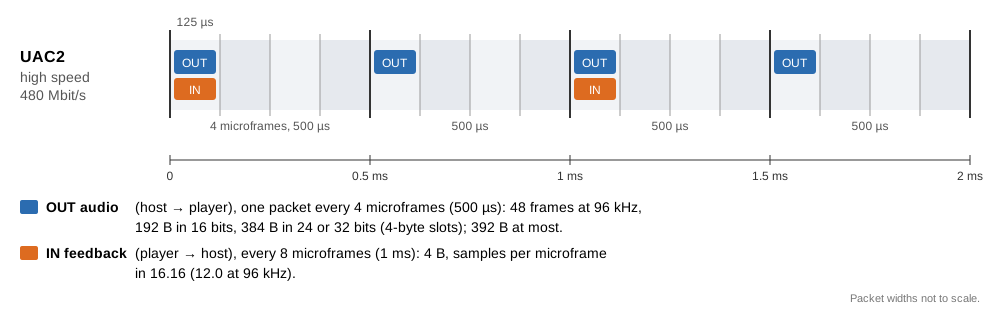 UAC2 at high speed, as the firmware does it: an audio packet every 4 microframes, the feedback every 8.
The next image worked: six sample rates from 44.1 to 192 kHz, zero samples dropped or repeated, about 6,000 interrupts per second.
…in 16 bits. When I played the same test in 24 bits the next morning, there was no sound at all. Linux showed a perfect feedback rate, but that was only because the device sends the nominal value when it receives nothing. The device’s counters said: zero packets received in four minutes.
The reason is the controller’s receive FIFO. The code was asking for 256 words, but the chip has no dynamic FIFO sizing (one bit in a hardware configuration register says so), so the FIFO stays at 147 words, 588 bytes, whatever you write. A 16-bit packet at 192 kHz (388 bytes) fits. A 24-bit packet in 4-byte slots (776 bytes) does not, and the controller drops it without any error. I added the value read back from the register to the log, and it said “rx fifo 147 words”. It also meant that the “256 words” in my notes from steps 1 and 2 was wrong.
The options were to send a packet every 250 µs (twice the interrupts), 3-byte slots (582 bytes: no room left at all), or stopping at 96 kHz. In UAC2, sample rates belong to the clock, not to the format, so I could not offer 192 kHz in 16 bits only.
The controller already generates thousands of interrupts per second; it is possible to push it a little further, but the device becomes very unresponsive and even the slightest interaction can cause frame loss. The 24-bit 176.4 and 192 kHz formats are already quite rare, reserved for archiving audio or masters that are to be processed or mixed. Personally, I don’t have any tracks in this format in my library. I’ve decided to limit the sampling rate to 96 kHz.
So the DAC feature now does 44.1, 48, 88.2 and 96 kHz in 16, 24 or 32 bits, with packets of 392 bytes at most. Result on the device: 167,708 packets, nothing dropped, repeated or re-aligned.
That’s great – we’re offering twice the sampling rate of the original firmware at 24-bit. Just one more test to go and we can release this feature!
The clock bug
The sound card logs the DACs’ real output rate, measured from the DMA’s progress over 10 seconds. During the 97R test, when 176.4 kHz was still offered, it said 175,912 Hz: 0.28 % slow.
The audio PLL settings come from the stock firmware’s tables. My audio player had been using the same ones since its first versions, so 176.4 kHz Audio had always been played 0.28 % slow, a pitch error about four times smaller than what a trained musician can notice. Nobody can hear that, and a test by ear could not catch it either. The sound card feature made it visible, because a feedback loop cannot settle on a rate that is not what it claims.
My first fix was wrong: I took one of the four PLL parameters for a fractional part and “doubled” the 44.1 kHz entry. The device played at 175,200 Hz, with horrible beeps. So I went back to the chip’s reference manual.
The PLL’s oscillator runs at 24 MHz × POSDIV / PREDIV, where POSDIV is an 11-bit number split across two registers (8 high bits in one, 3 low bits in the other). Then an output divider follows, coded rather than direct: the stock tables list the expected output frequency next to each entry, which gives the code-to-divider mapping. Yes, it’s horribly complicated just to set a frequency.
Each table entry has four parameters: POSDIV = 8 × the second + the 3 low bits of the first, PREDIV = the third, and the fourth is the output divider code (3 → ÷5, 8 → ÷9, 9 → ÷3, 10 → ÷6). Downstream, the clock unit divides the PLL output by 5 to make the I2S master clock (MCLK), and the I2S block divides MCLK again to get the bit clock, 64 × the sample rate. With that formula, every entry in the original stock tables gives:
| POSDIV / PREDIV |
VCO |
Output divider |
PLL output |
MCLK (÷5) |
Sample rates (I2S divider) |
On the device |
| 147 / 25 |
141.12 MHz |
÷5 |
28.224 MHz |
5.6448 MHz |
11.025 (÷8), 22.05 kHz (÷4) |
no clock at all |
| 384 / 50 |
184.32 MHz |
÷9 |
20.48 MHz |
4.096 MHz |
8 (÷8), 16 kHz (÷4) |
exact |
| 192 / 25 |
184.32 MHz |
÷6 |
30.72 MHz |
6.144 MHz |
12 (÷8), 24 kHz (÷4) |
exact |
| 294 / 25 |
282.24 MHz |
÷5 |
56.448 MHz |
11.2896 MHz |
44.1 (÷4), 88.2 kHz (÷2) |
exact |
| 768 / 50 |
368.64 MHz |
÷9 |
40.96 MHz |
8.192 MHz |
32 kHz (÷4) |
exact |
| 384 / 25 |
368.64 MHz |
÷6 |
61.44 MHz |
12.288 MHz |
48 kHz (÷4) |
exact |
| 384 / 25 |
368.64 MHz |
÷3 |
122.88 MHz |
24.576 MHz |
96 (÷4), 192 kHz (÷2) |
exact |
| 588 / 25 |
564.48 MHz |
÷5 |
112.896 MHz |
22.5792 MHz |
176.4 kHz (÷2) |
0.28 % slow |
| 768 / 25 |
737.28 MHz |
÷9 |
81.92 MHz |
16.384 MHz |
64 (÷4), 128 kHz (÷2) |
far too slow |
The bad entries are exactly the ones whose oscillator falls outside 184–369 MHz. The stock parameters are correct on paper; the silicon just does not follow. Months ago I had replaced the 11.025/22.05/64/128 kHz entries with proven PLLs (from TRM documentation and SDK) and different clock ratios without knowing why the stock ones failed. The stock firmware drives the PLL outside the range it can hold, and nobody seems to have checked the accuracy of those entries. The stock firmware does a lot of overclocking, out-of-spec stuff and its frequency adjustment makes no sense; that’s not a surprise.
The fix for 176.4 kHz is to use the 44.1 kHz PLL (282 MHz) and halve the I2S divider. I also added a permanent measurement of the output rate to the player’s log, at each track change. On the player’s test folder, all 15 sample rates from 8 to 192 kHz are now exact, to the 0.015 % precision of a 7-second track.
The table the firmware uses now has only three oscillator frequencies, all inside the proven range. Rates in bold no longer use their stock entry:
| VCO |
PLL output |
MCLK |
Sample rates (I2S divider) |
| 184.32 MHz |
20.48 MHz |
4.096 MHz |
8 kHz (÷8), 16 kHz (÷4) |
| 184.32 MHz |
30.72 MHz |
6.144 MHz |
12 kHz (÷8), 24 kHz (÷4) |
| 282.24 MHz |
56.448 MHz |
11.2896 MHz |
11.025 kHz (÷16), 22.05 kHz (÷8), 44.1 kHz (÷4), 88.2 kHz (÷2), 176.4 kHz |
| 368.64 MHz |
40.96 MHz |
8.192 MHz |
32 kHz (÷4), 64 kHz (÷2) |
| 368.64 MHz |
61.44 MHz |
12.288 MHz |
48 kHz (÷4) |
| 368.64 MHz |
122.88 MHz |
24.576 MHz |
96 kHz (÷4), 128 kHz (÷3), 192 kHz (÷2) |
One last false alarm
During the final tests I heard a click at every stream start. I suspected the ring, the DAC reconfiguration, the volume ramp… The test tones were sine waves that started abruptly, and an abrupt start clicks on any DAC. With a 50 ms fade-in, the clicks were gone. Make your test signals clean before you blame the device.
Why bother with 0.28 %?
A 0.28 % error is a twentieth of a semitone. No one will hear it on a pop song, so why spend an evening on it?
The player and the computer have to agree on the clock to within a few ppm, and 0.28 % is 2,800 ppm. The higher the frequency, the shorter the feedback loop becomes, and the greater the risk of it diverging. It is therefore necessary to achieve a stable sampling rates of 96 kHz.
It’s not just about displaying a high sampling rate; it has to make sense. It is possible to achieve a very high sampling rate by dropping or replaying microframes, or by running at an incorrect and unstable speed. Hence the aim of being ‘bit-perfect’. One hour of music played with a delay of 0.28 per cent lasts ten seconds longer, and a video played in parallel becomes desynchronised in the same way.
Because a PLL outside its range is not a stable clock. The same setting gave no clock at all at 141 MHz and a clock far too slow at 737 MHz. At 564 MHz it was only slightly off, on my unit and at room temperature. Another unit, or a colder morning, could have done worse. A setting that only works “most of the time” is a bug that hasn’t shown up yet.
Finally this small error explained the big ones. Once I understood why 176.4 kHz was off, I understood why 11.025, 22.05, 64 and 128 kHz had failed months earlier, which I had fixed without knowing why. One bug that is understood is worth three that are only patched.
How I tested
Everything was tested on a Linux PC first, without PulseAudio or PipeWire in the way:
aplay -D hw:3,0 tone.wav sends the file to the card untouched (no resampling, no mixing);sox -n -r 96000 -b 32 -c 2 tone.wav synth 6 sine 440 vol 0.2 fade t 0.05 6 0.05 makes the tones;/proc/asound/card3/stream0 shows the alternate setting in use, the packet size and, most useful of all, the feedback rate the host is reading (“Momentary freq”);- the device itself logs packets received, dropped, repeated and missed, the fill of its ring, the feedback value and the measured output rate, to a text file I read after each session.
The firmware was written mostly by Claude Code. I did the listening tests on the device; the analysis of each log was done with a bunch of python script.
Lessons learn
- Check what the hardware actually did. Writing 256 to a register does not give you 256 words, so read the value back and log it.
- Measure, don’t listen. A 0.28 % error is inaudible and was there from the first version. A rate measurement found it in ten seconds.
- Don’t trust copied parameters. The 176.4 kHz PLL setting came from the stock firmware and had been carried over, unchanged. Now that LLMs make reverse engineering easier, everyone is pulling the same values from the same binary file without too much checking.
- A failure has a range. Three wrong PLL entries looked like three unrelated bugs; plotted against one number, they were one.
- When a control loop misbehaves, look at what it controls first. The beeps of step 2 were not a USB problem, they came from a bad estimate of the DACs’ rate.
- Clean test signals. Half an hour lost to a click that was in the WAV file.
Next steps
- Some long listening sessions
- Android and iPhone (and the question of how much current a phone will give)
- A choice screen when the cable is plugged in,
- HID media keys.
The full details, in French, are in the project’s study notes, sections 83 to 88, and v0.98 is on GitHub.
Erratum (2026-11-01)
It took less than a day for reality to review this article.
- Phones ignore the feedback. A Pixel 6a and an iPhone read it every millisecond, then politely ignore it, whatever the format. So, “bit-perfect” holds with Linux; with phones, version 0.99 drops a sample now and then, evenly spread. Inaudible, but humbling. (Reported to Google.)
-
192 kHz in 24 bits works. I explained at length why a packet every 250 µs would choke the device. I had never tried it: I had jumped from one packet per microframe (which failed) straight to 500 µs. At 250 µs, 192 kHz is 48 frames of 8 bytes, plus one for the drift: 392 bytes, which fits in the 147-word FIFO (588 bytes, minus a status word). Better still, with a packet every two microframes the packets always land on the same frame parity, so re-arming the endpoint is no harder than at 500 µs. Only the 24- and 32-bit formats switch to 250 µs; 16 bits stays at 500 µs, where 192 kHz already fits (97 × 4 = 388 bytes). Result: about 6,000 interrupts per second at 192 kHz, 65 µs at most, nothing dropped, and the device stays perfectly usable. Version 0.99 does 44.1 to 192 kHz in every format.
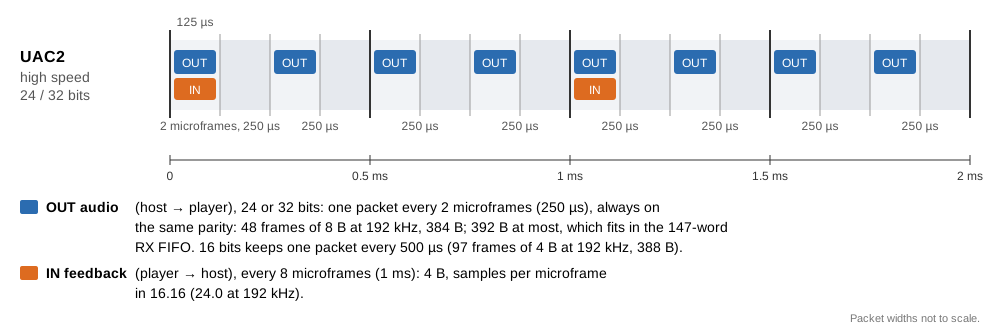 UAC2 at high speed in 0.99, 24 and 32 bits: an audio packet every 2 microframes, the feedback every 8.
- Step 1 was adaptive, not synchronous. Wrong word, same drift.
Details for the brave in docs/USB_AUDIO.md; v0.99 is on GitHub.
2022-12-21 - guiral Lacotte
“Vous rêvez de décrocher votre prochain emploi dans le monde de la technologie, mais vous êtes stressé à l’idée de devoir passer un test de programmation en Python? Ne paniquez pas! Dans cet article, je vous raconte comment j’ai utilisé GPT-3, l’un des modèles de traitement du langage naturel les plus avancés au monde, pour réussir haut la main un test de programmation en Python lors d’un entretien d’embauche. Suivez mes conseils et vous serez prêt à affronter n’importe quel test de programmation en toute confiance.” – ChatGPT
Je perdais mon temps sur Twitter lorsque je suis tombé sur ce tweet qui proposait de passer un test en Python qui serait représentatif de ce qui pourrait être demandé lors d’un entretien d’embauche. L’exercice consistait à implémenter un interpréteur BrainFuck, un langage de programmation étrange et volontairement incompréhensible. L’exercice était interessant, je n’avais jamais codé d’interpreteur j’ai décidé de relever le défi.
Après quelques recherches sur GitHub, j’ai trouvé un interpréteur BF en Python 3 déjà fonctionnel. Je l’ai copié-collé sur la page coderpad.io et j’ai effectué quelques modifications pour utiliser les bons tampons. Lorsque j’ai lancé l’évaluation, j’ai obtenu un score modeste de 6 sur 15. J’ai passé un peu plus de temps sur le problème en fin de journée et j’ai obtenue le 15 sur 15. Fin de l’histoire tout le monde s’en fout.
Les choses interessante arrivent après, je poste donc fièrement mon résultat sur Twitter. Parmi les nombreuses réponses au tweet original, l’une d’elles attire mon attention.
“NUL pour un entretien
Déjà chatgpt va le coder à sa place
Ensuite python pour faire des algos de ce type c’est juste pas le bon langage
Ensuite tu demandes au dev plusieurs centaines de lignes alors qu’un dev ça code 10 lignes par jour
Puis demander un algo étudient à un pro 😑” –@dededede4
Lors de mes précédents tests j’ai pue vérifier qu’il était déjà tout à fait possible de tricher en utilisant des outils comme GitHub Copilot, mais cela nécessite des connaissances en programmation. Mon idée et défi consiste à essayer de produire une solution sans écrire moi-même une seule ligne de code, voire sans apporter aucune modification. Le NoCode est à la mode, c’est l’occasion de tester.
Voici les règles du défi:
- Le résultat doit être obtenu à partir d’une seule demande à GPT-3/ChatGPT.
- La demande doit être faite en français.
- La demande doit être effectuée dans une nouvelle conversation.
Approche naïve
Requette:Je voudrais un interpreteur brainfuck en python 3.
Résultat:
#!/usr/bin/env python3
import sys

def run_bf(bf_code, input_str):
    input_chars = list(input_str)
    input_len = len(input_chars)
    input_index = 0

    # Initialise la mémoire à zéro
    memory = [0]
    pointer = 0

    # Initialise la sortie à une chaîne vide
    output = ""

    # Itère sur chaque caractère du code Brainfuck
    for c in bf_code:
        if c == ">":
            # Incrémente le pointeur de mémoire
            pointer += 1
            if pointer == len(memory):
                memory.append(0)
        elif c == "<":
            # Décrémente le pointeur de mémoire
            pointer -= 1
        elif c == "+":
            # Incrémente la valeur à l'emplacement de mémoire actuel
            memory[pointer] = (memory[pointer] + 1) % 256
        elif c == "-":
            # Décrémente la valeur à l'emplacement de mémoire actuel
            memory[pointer] = (memory[pointer] - 1) % 256
        elif c == ".":
            # Ajoute la valeur de l'emplacement de mémoire actuel à la sortie
            output += chr(memory[pointer])
        elif c == ",":
            # Lit un caractère de l'entrée et le stocke à l'emplacement de mémoire actuel
            if input_index < input_len:
                memory[pointer] = ord(input_chars[input_index])
                input_index += 1
            else:
                memory[pointer] = 0
        elif c == "[":
            # Si la valeur de l'emplacement de mémoire actuel est nulle, saute au caractère de fermeture de la boucle
            if memory[pointer] == 0:
                loop_count = 1
                while loop_count > 0:
                    c = bf_code[i]
                    i += 1
                    if c == "[":
                        loop_count += 1
                    elif c == "]":
                        loop_count -= 1
        elif c == "]":
            # Si la valeur de l'emplacement de mémoire actuel n'est pas nulle, saute au caractère d'ouverture de la boucle
            if memory[pointer] != 0:
                loop_count = 1
                while loop_count > 0:
                    c = bf_code[i]
                    i -= 1
                    if c == "[":
                        loop_count -= 1
                    elif c == "]":
                        loop_count += 1

    return output

def main():
    # Vérifie qu'un fichier a été passé en argument
    if len(sys.argv) != 2:
        print("Utilisation: bf.py fichier.bf")
GPT-3 nous donne un interpréteur BF fonctionnel qui semble avoir été copié-collé depuis un dépôt quelconque, mais c’est un bon début.
30 minutes plutard
Requete: Je voudrai un interpreteur brainfuck en python 3 sous la forme d’une fonction qui prend en entrer le code sous la forme d’un array nomé brainfuck_code et les entrées utilisateurs sous la forme d’un array nomé def solution user_input. La mémoire est cyclique et fait 30000 cellules. Les entrée mémoire sont des bytes non signés.
Résultat:
Voici comment vous pourriez écrire une fonction en Python 3 qui interprète du code Brainfuck. Cette fonction prend en entrée une chaîne de caractères représentant le code Brainfuck et une chaîne de caractères représentant les entrées utilisateur, et retourne une chaîne de caractères représentant la sortie générée par le code Brainfuck:
def interpret_brainfuck(brainfuck_code, user_input):
    # Créer une liste de 30000 bytes non signés pour la mémoire
    memory = [0] * 30000

    # Initialiser les variables d'instruction et de pointeur de mémoire
    instruction_ptr = 0
    memory_ptr = 0

    # Initialiser la sortie à une chaîne vide
    output = ""

    # Initialiser l'index de l'entrée utilisateur à 0
    input_idx = 0

    # Répéter jusqu'à ce que l'instruction pointée soit "EOF" (fin de fichier)
    while brainFuck_code[instruction_ptr] != "EOF":
        # Récupérer l'instruction actuelle
        instruction = brainFuck_code[instruction_ptr]

        # Exécuter l'instruction en fonction de sa valeur
        if instruction == ">":
            # Incrémenter le pointeur de mémoire
            memory_ptr += 1
        elif instruction == "<":
            # Décrémenter le pointeur de mémoire
            memory_ptr -= 1
        elif instruction == "+":
            # Incrémenter la valeur de la cellule de mémoire pointée
            memory[memory_ptr] += 1
        elif instruction == "-":
            # Décrémenter la valeur de la cellule de mémoire pointée
            memory[memory_ptr] -= 1
        elif instruction == ".":
            # Ajouter la valeur de la cellule de mémoire pointée à la sortie
            output += chr(memory[memory_ptr])
        elif instruction == ",":
            # Lire l'entrée utilisateur et affecter sa valeur à la cellule de mémoire pointée
            memory[memory_ptr] = ord(user_input[input_idx])
            input_idx += 1
        elif instruction == "[":
            # Si la valeur de la cellule de mémoire pointée est 0, sauter à la correspondance de "]"
            if memory[memory_ptr] == 0:
                instruction_ptr = brainFuck_code.index("]", instruction_ptr)
        elif instruction == "]":
            # Si la valeur de la cellule de mémoire pointée n'est pas 0, retourner à la correspondance de "["
            if memory[memory_ptr] != 0:
                instruction_ptr = brainFuck_code.index("[", 0, instruction_ptr)

        # Passer à l'instruction suivante
        instruction_ptr += 1
Le code comprend des commentaires en français, ce qui est positif. GPT-3 a également respecté la demande de produire une fonction et de donner des noms de variables appropriés.
Cependant, il y a quelques points à améliorer:
- La fonction ne retourne pas de valeur de sortie.
- La mémoire n’est pas implémentée de manière cyclique (elle ne retourne pas à zéro une fois qu’elle atteint la fin de la liste).
- Les entrées ne sont pas traitées comme des entiers, mais comme des chaînes de caractères.”
Après avoir effectué plusieurs tests, j’ai constaté que dans sa version d’essai gratuite, GPT-3 tronquait les réponses qui étaient trop longues lorsque le service était surchargé, ce qui expliquait l’absence de retour de la fonction plutôt qu’un oubli réel de la part du système. On abandonne le code doit être généré en une seul fois.
Requete: la fonction doit retourner la sortie.
Réponse: Pour retourner la sortie générée par le code Brainfuck, il suffit de retourner la chaîne de caractères output à la fin de la fonction interpret_brainFuck. Voici comment la fonction complète pourrait ressembler: …
Requete: La mémoire doit être cyclique.
Réponse: Pour que la mémoire soit cyclique dans l’interpréteur BrainFuck que j’ai proposé, vous pouvez ajouter un modulo 30000 aux opérations d’incrémentation et de décrémentation du pointeur de mémoire. Cela permettra de s’assurer que le pointeur de mémoire reste compris entre 0 et 29999, ce qui correspond aux limites de la mémoire cyclique de 30000 cellules. Voici comment la fonction pourrait être modifiée pour prendre en compte la mémoire cyclique: …
Requete: Les cellules mémoires sont des entiers non signés compris entre 0 et 255.
Pour que les cellules de mémoire soient des entiers non signés compris entre 0 et 255, vous pouvez utiliser le type de données bytes de Python, qui est une séquence immutable d’octets. Vous pouvez créer une liste de 30000 octets non signés en utilisant la fonction bytes de Python et en initialisant chaque élément à 0. Voici comment la fonction interpret_brainFuck pourrait être modifiée pour utiliser des octets non signés pour les cellules de mémoire: …
C’est là que les choses deviennent intéressantes. Le commentaire introductif est plutôt juste, mais le code fourni ne le prend absolument pas en compte. Il recrache le code lors de l’étape précédente.
def interpret_brainFuck(brainFuck_code, user_input):
		...
        if instruction == ">":
            # Incrémenter le pointeur de mémoire de manière cyclique
            memory_ptr = (memory_ptr + 1) % 30000
        elif instruction == "<":
            # Décrémenter le pointeur de mémoire de manière cyclique
            memory_ptr = (memory_ptr - 1) % 30000
        elif instruction == "+":
            # Incrémenter la valeur de la cellule de mémoire pointée
            memory[memory_ptr] += 1
        elif instruction == "-":
            # Décrémenter la valeur de la cellule de mémoire pointée
            memory[memory_ptr] -= 1
Requête: Les valeurs stockées en mémoires sont comprises entre 0 et 255.
Réponse:Pour s’assurer que les valeurs stockées en mémoire restent comprises entre 0 et 255, vous pouvez utiliser l’opérateur modulo % dans les opérations d’incrémentation et de décrémentation des cellules de mémoire. Cela permettra de limiter les valeurs des cellules de mémoire à l’intervalle [0, 255]. Voici comment la fonction interpret_brainFuck pourrait être modifiée pour limiter les valeurs des cellules de mémoire à l’intervalle [0, 255]:
def interpret_brainFuck(brainFuck_code, user_input):
		...
        # Exécuter l'instruction en fonction de sa valeur
        if instruction == ">":
            # Incrémenter le pointeur de mémoire de manière cyclique
            memory_ptr = (memory_ptr + 1) % 30000
        elif instruction == "<":
            # Décrémenter le pointeur de mémoire de manière cyclique
            memory_ptr = (memory_ptr - 1) % 30000
        elif instruction == "+":
            # Incrémenter la valeur de la cellule de mémoire pointée de manière modulaire
            memory[memory_ptr] = (memory[memory_ptr] + 1) % 256
        elif instruction == "-":
            # Décrémenter la valeur de la cellule de mémoire pointée de manière modulaire
            memory[memory_ptr] = (memory[memory_ptr] - 1) % 256
        elif instruction == ".":
Au final, j’ai obtenu un code qui fonctionne, mais qui ne passe que 6 tests sur 15. Ce qui n’est pas trop mal si l’on considère que je n’ai écrit aucune ligne de code moi-même. J’ai refait l’exercice en anglais. Cette fois-ci GPT-3 s’en sort beaucoup mieux. Le temps de traitement était plus court, ce qui a permis de réduire les problèmes de troncature des réponses (probablement dus à un délai d’expiration) et il a mieux intégré les remarques. Le code suivant a obtenu un score de 8 sur 15 lors du test initial.
def solution(code, user_input):
    memory = [0] * 30000  # Memory with 30,000 cells, initialized to 0

    # Pointer to current cell in memory
    ptr = 0

    # Index of the current input character
    input_index = 0

    # Output string
    output = ''

    # Loop through each character in the code
    i = 0
    while i < len(code):
        # Get the current character and move to the next
        char = code[i]
        i += 1

        if char == '>':
            # Increment the pointer, wrapping around if necessary
            ptr = (ptr + 1) % len(memory)
        elif char == '<':
            # Decrement the pointer, wrapping around if necessary
            ptr = (ptr - 1) % len(memory)
        elif char == '+':
            # Increment the value at the current cell, wrapping around if necessary
            memory[ptr] = (memory[ptr] + 1) % 256
        elif char == '-':
            # Decrement the value at the current cell, wrapping around if necessary
            memory[ptr] = (memory[ptr] - 1) % 256
        elif char == '.':
            # Append the character with the ASCII value of the current cell to the output string
            output += chr(memory[ptr])
        elif char == ',':
            # Input a character from the user_input list and store its ASCII value in the current cell
            memory[ptr] = ord(user_input[input_index])
            input_index += 1
        elif char == '[':
            # If the value at the current cell is 0, jump to the corresponding ']'
            if memory[ptr] == 0:
                loop = 1
                while loop > 0:
                    char = code[i]
                    i += 1
                    if char == '[':
                        loop += 1
                    elif char == ']':
                        loop -= 1
        elif char == ']':
            # If the value at the current cell is not 0, jump back to the corresponding '['
            loop = 1
            while loop > 0:
                i -= 1
                char = code[i]
                if char == '[':
                    loop -= 1
    print('Output :', output)
    return output
Détecter les IA avec Python 3.10
GPT-3 ne connait que python jusqu’à la version 3.8, si on lui demande d’utiliser la fonction match/case introduite dans python 3.10 il perd les pédales et nous raccompte n’importe quoi.
Q: Pourrais-tu utiliser match case à la place de if elif ?
R: Oui, vous pouvez utiliser un dictionnaire et la fonction get pour remplacer les structures if et elif dans la fonction interpret_brainFuck. Le dictionnaire sera utilisé pour associer chaque instruction BrainFuck à une fonction qui effectue l’opération correspondante. Voici comment la fonction interpret_brainFuck pourrait être modifiée pour utiliser un dictionnaire et la fonction get:
def interpret_brainFuck(brainFuck_code, user_input):
	...
    operations = {
        ">": lambda: setattr(memory_ptr, (memory_ptr + 1) % 30000),
        "<": lambda: setattr(memory_ptr, (memory_ptr - 1) % 30000),
        "+": lambda: setattr(memory[memory_ptr], (memory[memory_ptr] + 1) % 256),
        "-": lambda: setattr(memory[memory_ptr], (memory[memory_ptr] - 1) % 256),
        ".": lambda: setattr(output, output + chr(memory[memory_ptr])),
        ",": lambda: setattr(memory[memory_ptr], ord(user_input[input_idx])),
        "[": lambda: setattr(instruction_ptr, brainFuck_code.index("]", instruction_ptr))
            if memory[memory_ptr] == 0 else None,
        "]": lambda: setattr(instruction_ptr, brainFuck_code.index("[", 0, instruction_ptr))
            if memory[memory_ptr] != 0 else None,
    }

    # Répéter jusqu'à ce que l'instruction pointée soit "EOF" (fin de fichier)
    while brainFuck_code[instruction_ptr] != "EOF":
        # Récupérer l'instruction actuelle et exécuter l'opération correspondante
        operations.get(brainFuck_code[instruction_ptr], lambda: None)()

        # Passer à l'instruction suivante
        instruction_ptr += 1

    # Retourner la sortie générée par le code BrainFuck
    return output
Dans cette version de la fonction, chaque instruction BrainFuck est associée à une fonction lambda qui effectue l’opération correspondante. Lorsque l’instruction est exécutée, la fonction lambda est appelée en utilisant la méthode get du dictionnaire ‘operations’.
Utiliser un dictionnaire de fonctions pourrait être une solution élégante pour résoudre ce problème, mais le code part complètement en vrille et définit des lambda avec des setattr avec deux arguments au lieu de trois. Ensuite, il attend un EOF sur un tableau. Si vous voulez casser GPT-3, demandez-lui de coder en Python 3.10.
Conclusion
En conclusion, est-ce que GPT-3 permet de tricher lors d’un entretien en temps limité et est-ce que le NoCode et les intelligences artificielles vont mettre les développeurs au chômage? La réponse est non. Tout d’abord, dans sa version gratuite, GPT-3 est assez lent à répondre. J’ai mis moins de temps à trouver un dépôt GitHub en utilisant Google qu’à attendre la réponse de GPT-3 lorsque j’ai fait la demande en français. Sans une compréhension fine des problémes les résultats fournis sont inexploitables. Il est difficile et inefficace de lui faire prendre en compte des détails d’implémentation tels que le bouclage mémoire ou certains comportements (débordement d’entier) lorsqu’on l’interroge en anglais, et presque impossible lorsqu’on l’interroge en français. Il sort n’importe quoi dès qu’on lui demande de coder dans un langage qui sort un peu de sa base d’apprentissage. Il pourrait être intéressant de comparer ses performances en fonction des langages et de leur popularité. Les résultats restent tout de même beaucoup plus impressionnants que la majorité de outils “NoCode” qui tiennent plus du légo, programmation visuel.
TL;DR : GPT-3 peut sortir du code identique à une bonne recherche google sur github, il peut commenter le code et le traduire, voir faire quelques modifications mineurs comme les noms de variables. Mais il est très difficile de lui faire faire plus de chose et c’est probablement plus lent que de le faire soit même. Si vous savez coder Github Copilot fait mieux.
2022-09-03 - guiral Lacotte
Voici un court article au sujet des boîtiers de pédalier Miche Evo Max et leur compatibilité avec les boîtiers de pédalier Shimano Hollowtech II.
Pourquoi, écrire cette article ? J’ai récément (juillet 2022) acheté un pédalier Miche Pistard 2.0 pour un vélo à pignon fixe. Le fabricant annonce que seul les boîtiers de pédalier de la gamme Miche Evo Max sont compatible avec ce modèle. Cela semble plutôt évident vue qu’ils n’ont que deux gammes de boîtiers, axe carré JIS et Evo Max.
 J’ai donc acheté par la même occasion un boîtier Miche Evo Max au format BSA 68mm (les cadres piste reprennent le standard route). Premières constations le boîtier fait plutôt bas de gamme, les flasques sont en aluminium non anodisé et ne comportent aucune indication de montage. Les indications droite, gauche et le sens de serrage auraient été des miniums.
Les tolérances
Les boîtiers Shimano ou Sram auxquels vous êtes probablement habitué se montent comme dans du beurre. Mon exemplaire de boîtier Miche Evo Max avait des tolérences vraiment mauvaises, ce qui rend le montage pénible. Il y a du jeu d’un côté et c’est serré de l’autre.
L’axe du pédalier est mal guidé dans le boîtier on a donc de fortes chances d’ejecter le cache plastique du roulement gauche, expérience vécue. Même en faisant les choses mal ce genre d’ejection ne m’est jamais arrivé sur un boitier Shimano. Avec tous les frottements, il est difficile de savoir si l’on a atteint le couple de serrage recommandé et si l’on est bien en butté lors du montage. J’ai serré aux 47 Nm recommandé et j’avais encore du jeu axial lors des skids. Ce qui était particulièrement désagréable.
Les montages de roulements sur les boitiers de pédalier
Miche affirme que ses pédaliers ne sont compatibles qu’avec ses propres boîtiers. Cependant, lorsque l’on vérifie les dimensions, on constate que l’axe du pédalier a un diamètre de 24 mm à gauche et à droite, le boîtier standard BSA 68 mm. Ces dimensions correspondent aux dimensions des pédaliers Hollowtech II de Shimano. Il faut toujours se méfier avec les tolérences de montages qui peuvent différés. Mais j’ai donc essayé de monter un boîtier Shimano ULTEGRA SM-BBR60 BSA Hollowtech II sur le pédalier Miche.
Les tolérances de l’axe de pédalier Miche sont soit légèrement différentes de celles d’un pédalier Shimano, soit les tolérences de l’axe et le control qualité chez Miche sont mauvaise (ce qui semble plus probable), car il y avait un peu de frottement lors du montage. J’ai passé le pédalier au congélateur afin de contracter légèrement l’arbre, ce qui a permis de monter le boîtier sans aucun effort ou frottement. Une fois serré au couple recommandé, il n’y avait plus de jeu, plus de bruit et plus la désagrable impression que l’on va perdre une manivelle dés qu’on part un peu de travers.
Conclusion
Avec la fin des pédaliers excellents SRAM Omnium, le pédalier Miche Pistard constitue une bonne alternative à un prix abordable. Les boîtiers de pédaliers Miche sont chers, difficiles à trouver et de mauvaise qualité. Bien que le fabricant affirme le contraire il est tout à fait possible de monter un boîtier Shimano de bien meilleur qualité sur un pédalier Miche.
TL;DR : BB Miche caca, BB Shimano ca passe sur un Miche Pistard 2.0
2020-04-01 - guiral Lacotte
 En ces temps de confinement Covid-19, j’ai enfin prit le temps d’effectuer quelques projet que j’avais dans mes calpins depuis un certain temps. L’un d’eux etait d’effectuer un maximum de demandes d’accès à mes données personnels via la GDPR et d’étudier les données qui m’étaient envoyés. Cela afin d’évaluer la mise en oeuvre de la GDPR par les différentes entreprises et plateformes. De détailler les modalités d’accès, car j’en connais quelque uns d’entre vous pour qui il est plus de facilités a écrire une requête vers une API que d’écrire une lettre manuscrite avec photocopie de pièce d’identité vers la boite postale du service juridique (regard accusateur en direction du système bancaire et les opérateurs télécoms français). Mais aussi de mieux comprendre, le fonctionnement et le modèle économique de ces plateformes. Et enfin, avoir des données réels afin de m’exercer à la visualisation de données de géolocalisation avec Python, Folium et Leaflet.
Le but est de faciliter le travail pour des néophytes et d’encourager les utilisateurs a exercer leurs droits d’accès (un droit que l’on utilise pas c’est un droit qui meure). Il n’est pas prévue de se lancer dans des analyses complexes (reverse d’application mobile ou d’API, dés-anonymisation). Je n’ai malheureusement ni le temps, ni les compétence requise pour le faire.
Dans le premier article, je vais m’attaquer à la plateforme Uber. Ce n’est pas la première analyse que j’ai effectué mais c’est l’une des plus intéressantes et celle qui touche la population la plus importante.
La demande d’accès
On peut demander ses donnée directement depuis le site de Uber via cette page: help.uber.com/riders/... Pour effectuer la demande il faut avoir conservé son compte Uber et le numéro de téléphone utilisé lors de l’enregistrement de l’application mobile. L’authentification sur le site web depuis un nouvel appareil et pour ce type de demande nécessite de l’authentification deux facteurs qui s’effectue par l’envoie d’un code par SMS. Comparativement a mes autres demandes qui nécessite souvent de passer par des échanges de mails avec le responsable GDPR de la société, cela reste plutôt simple. Ma demande a été traité en une trentaine d’heure, ce qui est là aussi plutôt bien. On reçoit un lien par mail qui pointe vers une page de téléchargement. Le lien est valide que 7 jours et la page nécessite une authentifier deux facteurs. Les données sont envoyé sous forme d’une archive ZIP contenant une arborescence et plusieurs fichiers CVS.
En ce qui concerne la demande d’accès, la transmission et sécurité, Uber fait partie des bons élèves.
Les données collectées et transmises
Les données collectées par Uber et transmises dans le cadre des demandes GDPR sont listées là : help.uber.com/riders/..
Ce qui va particulièrement m’intéresse ce sont les données de géolocalisation.
DONNÉES DU PASSAGER Vos données de passager contiennent les informations utilisées pour vous amener à destination, notamment :
- Les détails des courses tels que les heures et lieux de demande, de début et de fin, ainsi que les distances parcourues ;
- le prix des courses et la devise utilisée ;
- 30 jours de données d’événements mobiles, telles que le système d’exploitation de l’appareil, le modèle de l’appareil, la langue de l’appareil, la version de l’application, ainsi que l’heure et le lieu de la collecte des données.
L’arborescence de l’archive est comme suit:
Uber Data/
├── Account and Profile
│   ├── payment_methods.csv
│   └── profile_data.csv
├── readme.html
├── Regional information
│   └── For_California_users.txt
└── Rider
    ├── rider_app_analytics-0.csv
    └── trips_data.csv
- payment_methods.csv : La liste des cartes et moyen de payment actuels ou passés.
- profile_data.csv : Correspond au profile utilisateur, on y trouve nos première donnée de géolocation via Signup Lat et Signup Long qui sont les coordonnées lors de l’enregistrement sur l’application. Le champ
Referred to Uber? correspond au code de vote éventuel parrain, le champ Referral Code correspond au code de parrainage.
- readme.html : Une copie de la page listant les données collectés.
- For_California_users.txt : Un utilisateur peu attentif pourrait ne passer ce fichier texte, mais celui-ci est en réalité très intéressant. Il liste les catégories de partenaires qui peuvent potentiellement avoir accès aux données collectés par Uber et les partenaires avec les quels Uber a échangé vos donnés lors des douze derniers moi. Par exemple dans mon cas:
In the past 12 months, Uber has sold your personal data to the following categories of third parties: -Advertising network providers. Uber est plutôt avare de détail au sujet de ses partenaires commerciaux.
- rider_app_analytics-0.csv : On attaque les choses sérieuses, ce fichier contient les “30 jours de données d’événements mobiles”. C’est une mine d’information et particulièrement d’information de géolocalisation. Le volume d’information est particulièrement étonnant . Fin Mars 2020 après deux semaines de confinement et une utilisation quasi nul de Uber exception faite des manipulation nécessaire à la demande d’accès, le fichier compte plus de 2000 lignes.
- trips_data.csv : Deuxième fichier particulièrement intéressant, celui-ci contient l’ensemble des “détails des courses tels que les heures et lieux de demande, de début et de fin, ainsi que les distances parcourues”, depuis l’enregistrement sur la plateforme.
rider_app_analytics-0.csv
Comme nous l’avons vue ce fichier comporte toutes les données d’événements mobiles.
A titre d’exemple, voici un extrait d’une interaction avec l’application. Lors d’une course à l’autre bout de Paris, suite à une panne sur l’une des ligne de métro j’ai lancé l’application afin d’évaluer l’opportunité de prendre un Uber ou les transports en commun. J’ai finalement pris les transports en commun sans effectuer de réservations. D’après les données d’horodatage, l’opération aura prit 2,966 secondes et aura générée 332 lignes d’événements.
Quand l’on dépouille le fichier, il apparaît que chaque ligne correspond à une interaction avec l’appli ou à une réquête de l’API d’Uber. On retrouve trois type d’ “Analytics Event Type”, custom, tap et impression. Chaque déplacement de la carte, zoom, dé-zoom, ou clic est enregistré.
le champ GPS Time (UTC) correspond à la date de la dernière position GPS connue.
Le champ Horizontal Accuracy correspond à l’écart type sigma de position horizontale. Il est particulièrement utile pour savoir si l’utilisateur est à l’intérieur ou à l’extérieur d’un bâtiment.
les champs Latitude,Longitude sont codés en degrés décimaux sur 5 décimales.
les champs Carrier MCC, Carrier MNC, correspondent au code Mobile_country_code et Mobile_Network_Codes, 208 01 correspond a Orange France.
le champ Device ID correspond au Google Play Services ID for Android
le champ IMEI number est vide. C’est peu être un résidu de donnée qui ne sont plus collectés, ou de manière conditionnel (en l’absence de Device ID, lors de l’enregistrement).
En résumé ce fichier nous permet de tracer tout les lieux et dates d’interaction de l’utilisateur avec l’application, même si celui-ci n’effectue aucune réservation. Il nous permet aussi de savoir si il était en intérieur ou à l’extérieur, en déplacement ou statique. Si l’utilisateur utilisent plusieurs terminaux il permet aussi d’identifier les terminaux, les réseaux mobiles utilisés, leurs modèles et la version du système d’exploitation.
Je n’ai malheureusement pas de donnée pour un trajet réel (reservation, prise en charge, trajet, dépose) sur cette période confinement oblique. Je ne suis pas en mesure d’évaluer la fenêtre temporel d’enregistrement de l’application lors d’un trajet. Je n’ai pas observé d’activité dans les journaux lors que l’application n’est pas en premier plan sur le téléphone.
trips_data.csv
C’est le fichier qui contient les journaux de”détails des courses tels que les heures et lieux de demande, de début et de fin, ainsi que les distances parcourues”. Il est de structure assez simple. Voici un exemple d’un aller retour, afin de préserver ma vie privé j’ai choisit un trajet légèrement éloigné de mes lieux de travail et d’habitation.
- City, Product Type, Trip or Order Status, Request Time, Begin Trip Time, Begin Trip Lat, Begin Trip Lng, Begin Trip Address, Dropoff Time, Dropoff Lat, Dropoff Lng Dropoff Address, Distance (miles), Fare Amount, Fare Currency
- Cape Town UberX COMPLETED 2019-02-15 19:42:32 +0000 UTC 2019-02-15 19:44:27 +0000 UTC -33.92129 18.41808 105 Bree St, Cape Town City Centre, Cape Town, 8001, Afrique du Sud 2019-02-15 19:51:24 +0000 UTC -33.90604 18.41783 3 Portswood Rd, V & A Waterfront, Cape Town, 8002, Afrique du Sud 1.66 31 ZAR
- Cape Town UberX COMPLETED 2019-02-15 17:28:51 +0000 UTC 2019-02-15 17:30:03 +0000 UTC -33.9060588 18.417833 3 Portswood Rd, V & A Waterfront, Cape Town, 8002, Afrique du Sud 2019-02-15 17:39:16 +0000 UTC -33.9244897 18.4195529 5 Wale St, Cape Town, 8001, ZA 1.94 40 ZAR
Chaque ligne correspond à un trajet, on retrouve les coordonnées de prise en charge Begin Trip Lat, Begin Trip Lng et de dépose Dropoff Lat, Dropoff Lng. Elles sont codées codés en degrés décimaux sur 5 décimales.
Ce fichier est moins verbeux que le précédents, mais nous permet de retracer l’ensemble de l’historique de réservation de l’utilisateur. On peut noter que dans une volonté de nous faciliter l’analyse Uber nous donne les adresses postales des lieux de prise en charge et de dépose, en français. Dans cet exemple on peut facilement identifier que j’effectuais un aller retour d’un hôtel vers un restaurant.
Visualisation des données de géolocalisation
Le code pour visualiser les points d’activité utilisateur et les trajets est disponible là:
https://github.com/berettavexee/Uber_map
C’est assez simple d’utilisation, il vous suffit de déposer vos fichiers rider_app_analytics-0.csv et trips_data.csv dans le sous repertoire uber et de lancer le script via python3 uber_map.py .
Conclusions
- Il est plutôt facile d’effectuer la demande d’accès GDPR.
- Les données fournies sont facilement exploitables.
- Uber possède un graph des parrainage
- Uber possède l’historique de toutes les interactions, qui inclue le dernier point de géolocalisation connue sur les 30 derniers jours.
- Uber conserve les données techniques en mesure d’identifier tous les appareils, réseau téléphonique et réseau IP utilisés sur les 30 derniers jours.
- Uber conserve un historique complete des trajets effectués.
- Certaines données fournit par l’utilisateurs comme la notation des chauffeurs ou des trajets n’ont pas été transmises.
remerciements
